RCNN
[
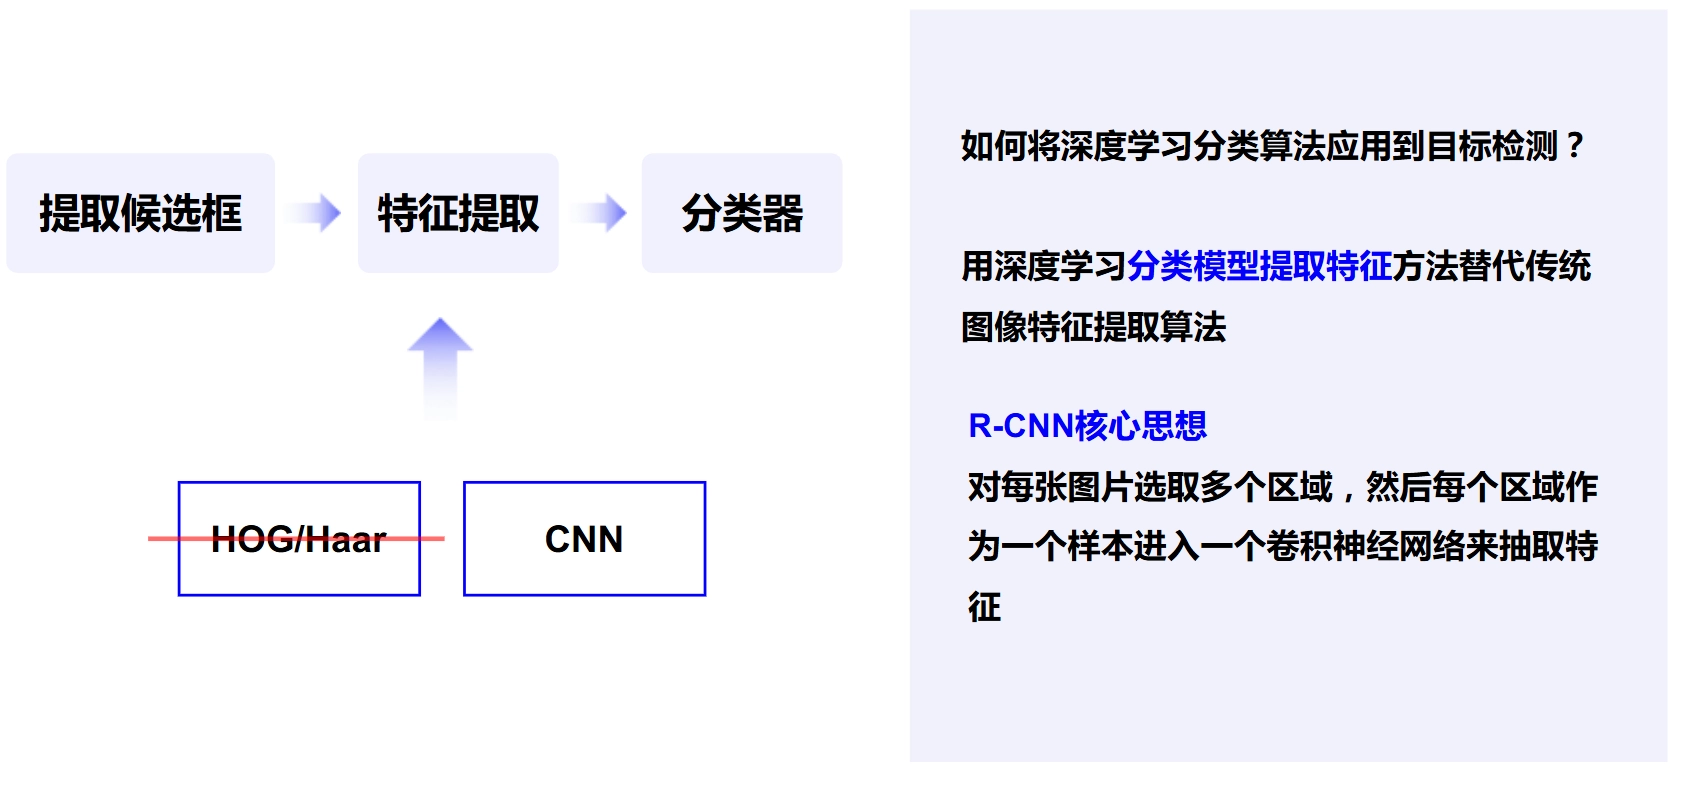
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523230243187-1128443870.png)
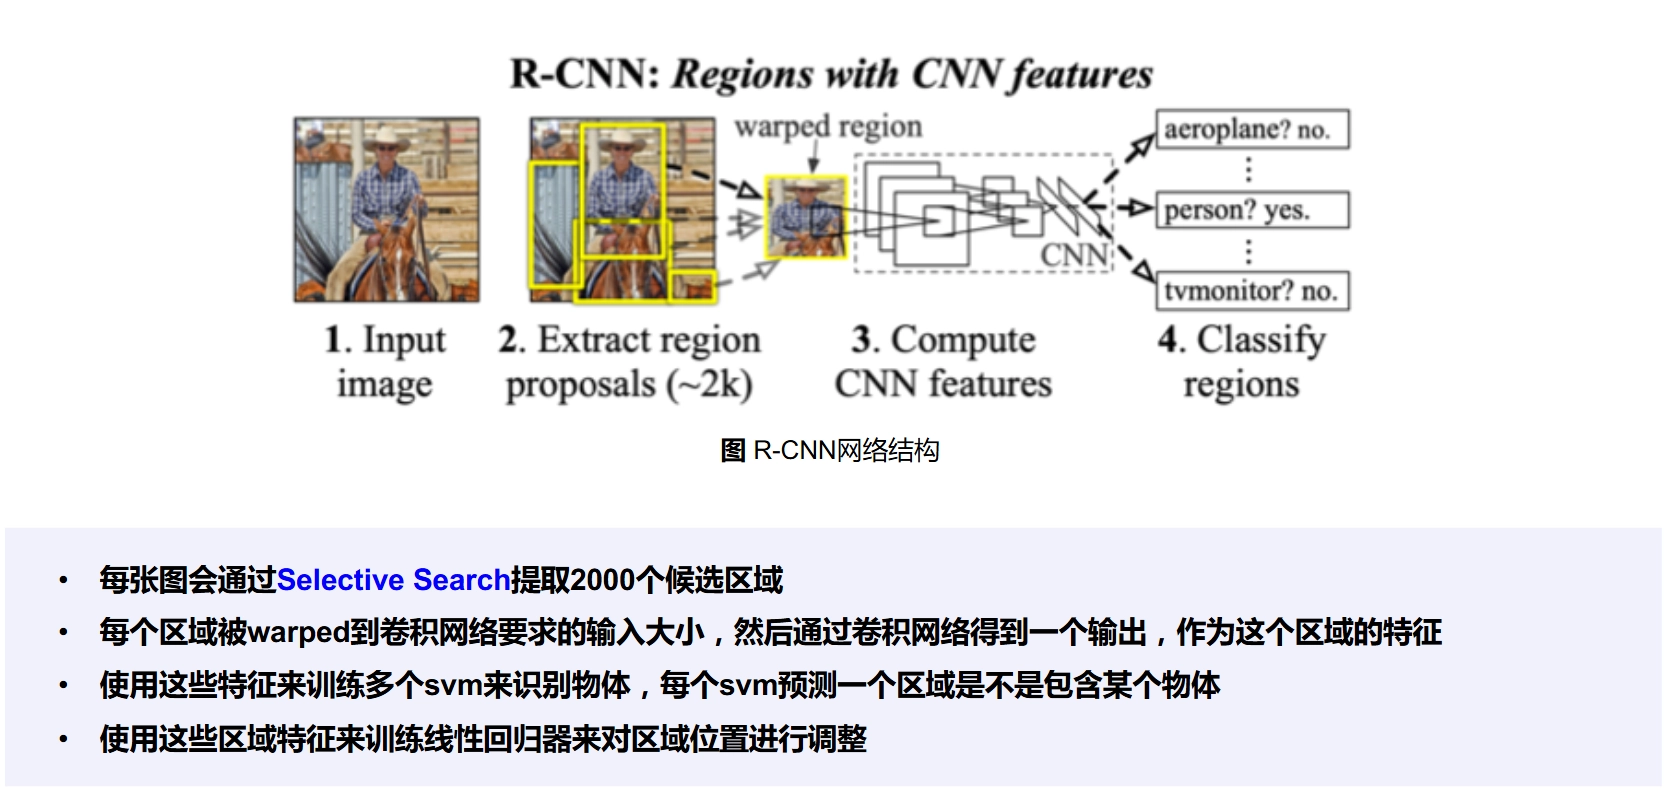
RCNN 网络结构#
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523230723576-51044624.png)
通过Selective Search获取候选区域然后区域压缩到卷积层要求的大小,然后将卷积神经网络的输出作为特征,用特征来训练多个svm来识别物体,通过这些特征来训练线性回归器来对区域位置进行调整
SVM(Support Vector Machine,支持向量机)是一种经典的监督学习算法,主要用于分类和回归任务。
当然SVM不是重点,我们来看看RCNN的优缺点以及后面的FAST RCNN和FASRER RCNN
RCNN 的优缺点
优点:
高准确率:相比传统方法,RCNN 在目标检测任务上取得了显著提升。
模块化设计:区域提议、特征提取、分类和回归分阶段进行,便于理解和改进。
缺点:
计算效率低:
需要对每个候选区域单独提取特征,导致计算冗余。
训练和推理速度慢,难以应用于实时场景。
存储开销大:需要存储所有候选区域的特征,占用大量磁盘空间。
没时间为RCNN哀悼,接下来登场的是Fast RCNN
核心思想:简化RCNN的计算复杂度
resize->通过RoI Pooling将每个区域分成很多小块,得到多个小块的最大值
svm+regressor->softmax+regressor
然而
Fast R-CNN还有不足
候选区域仍然采用Selective Search的方法,提取候选区域耗时长
Faster RCNN
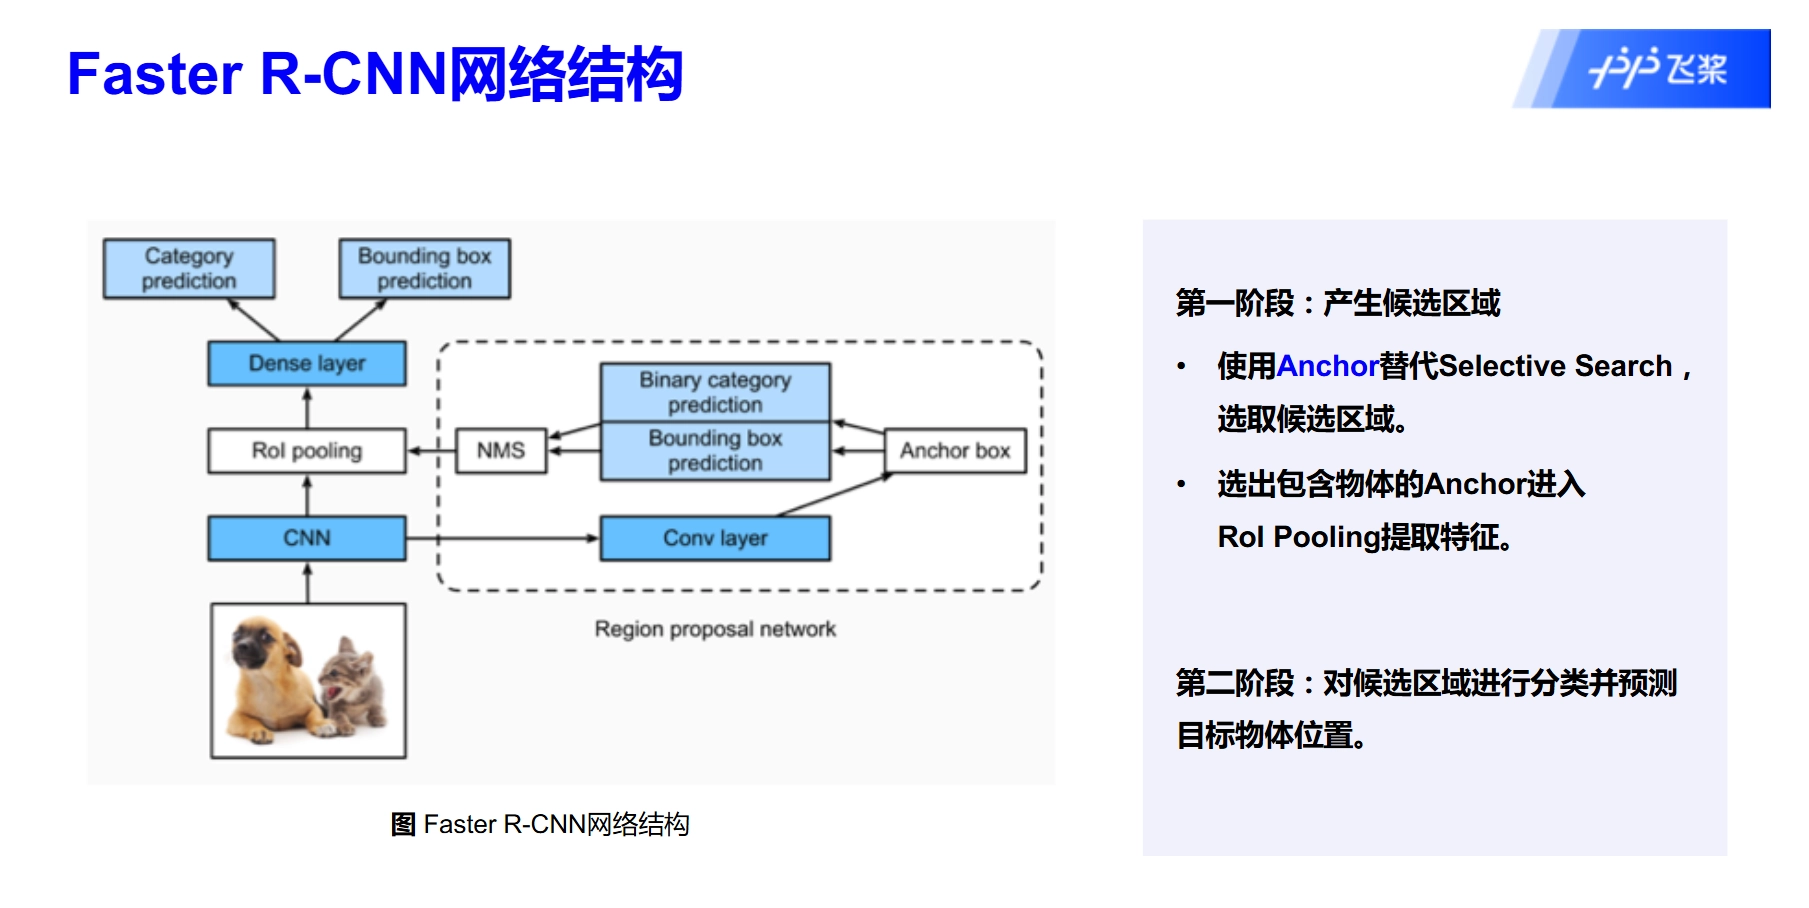
核心实现:使用RPN(Region Proposal Network) to replace Selective Search
网络结构
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523231851596-719434801.png)
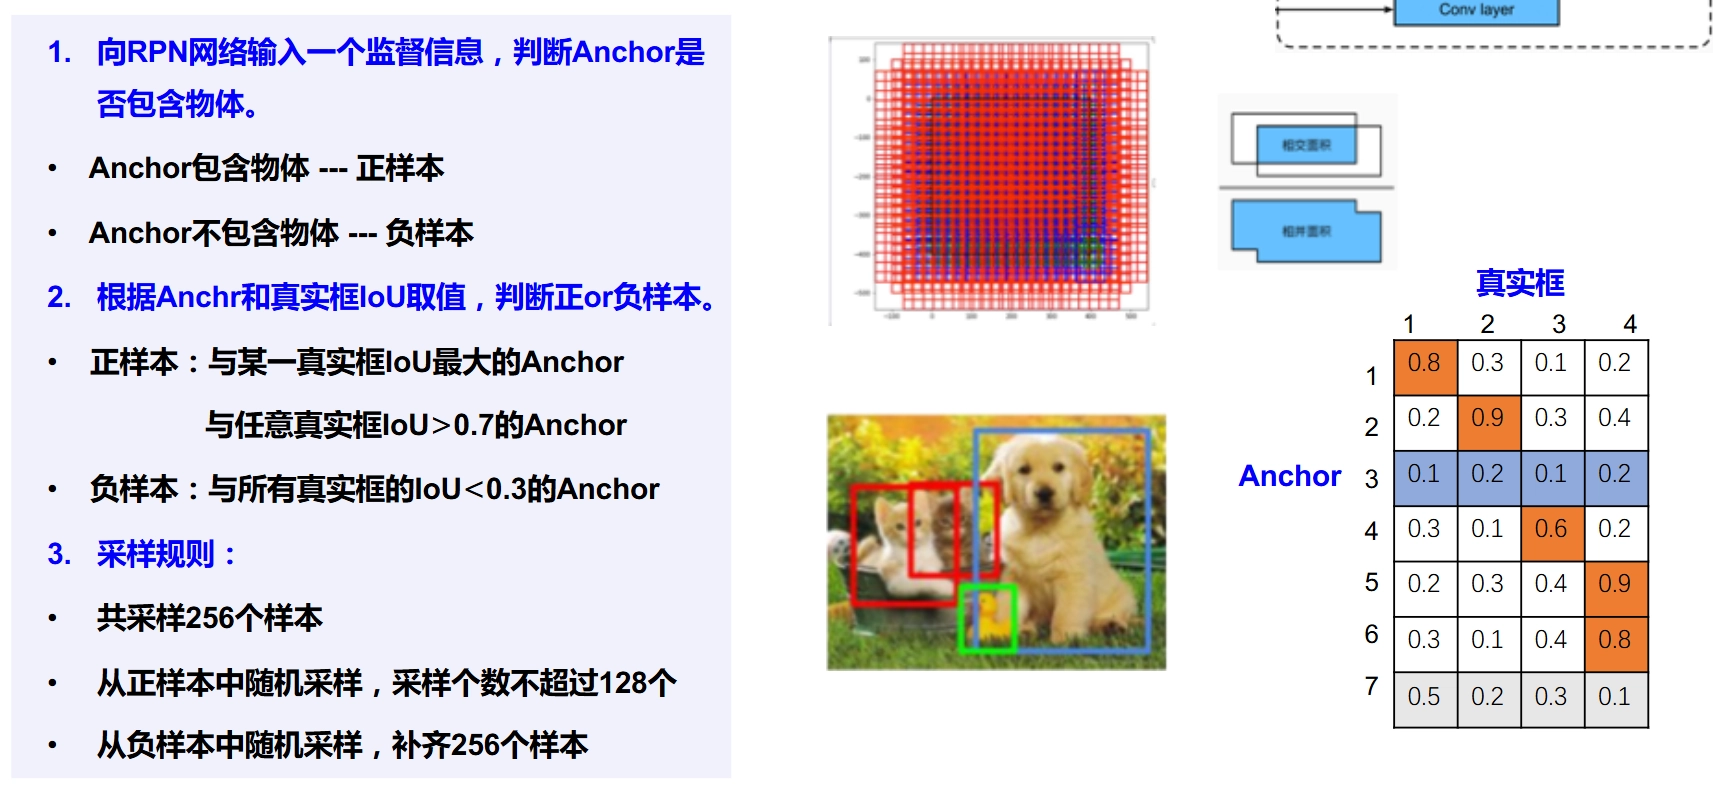
RPN训练策略#
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523231923519-2013243262.png)
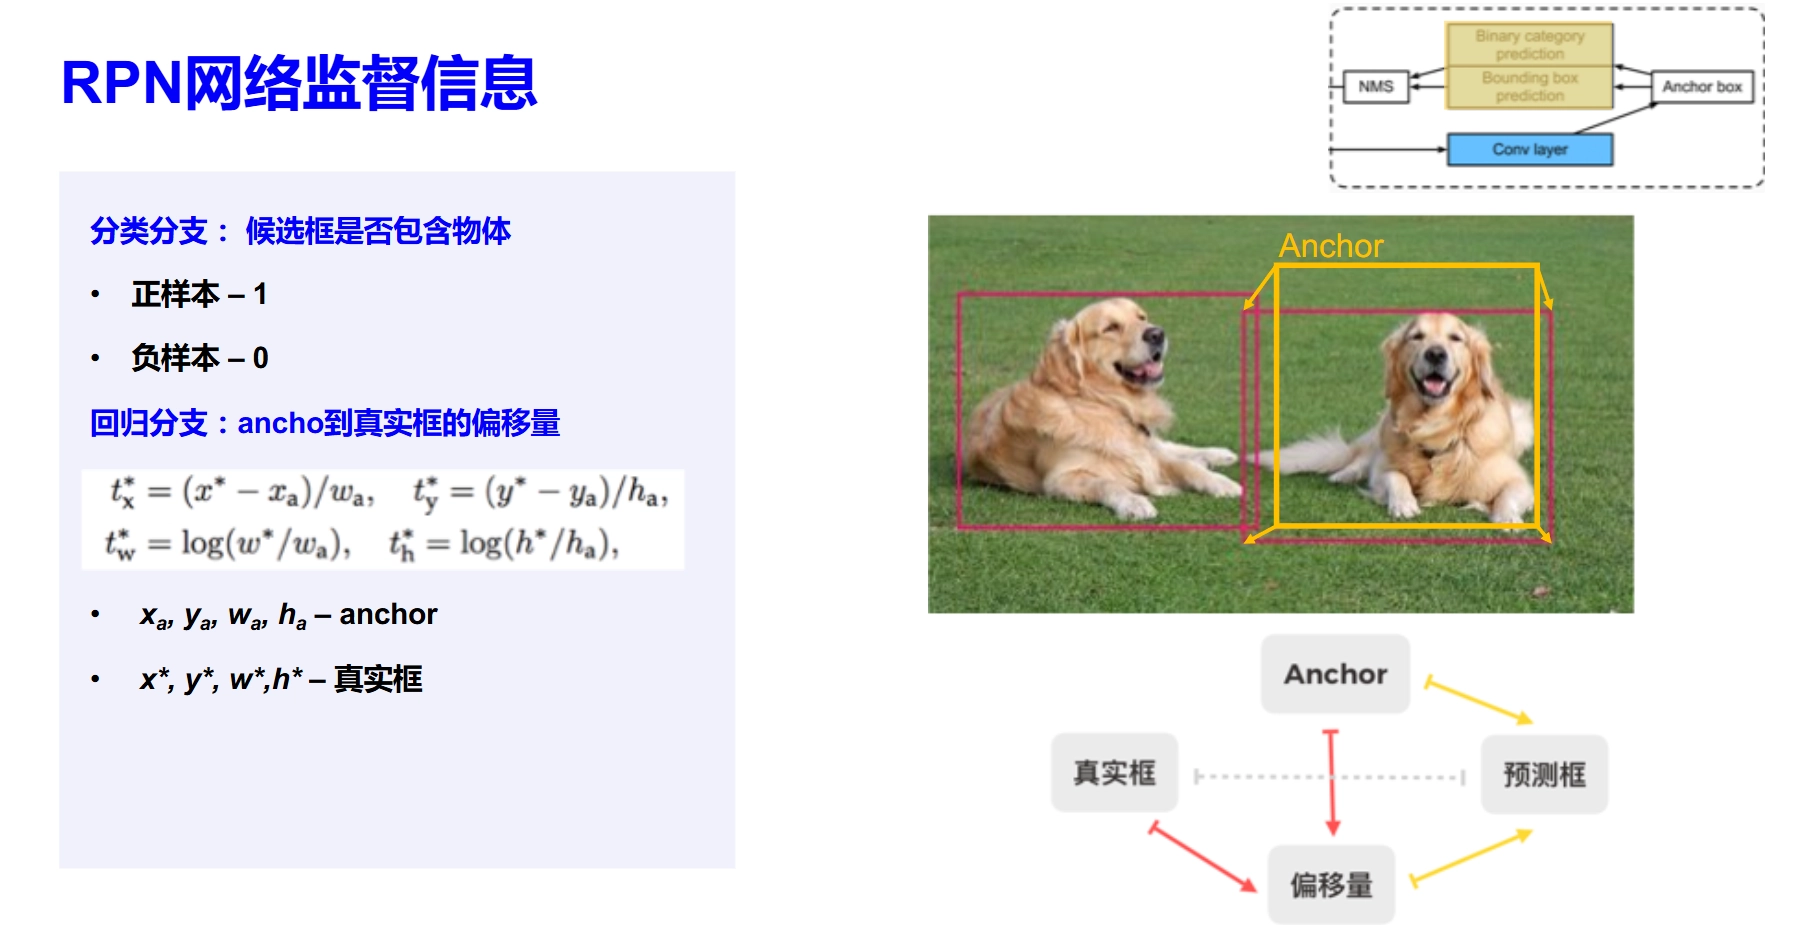
RPN网络监督信息#
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523231954978-1313460293.png)
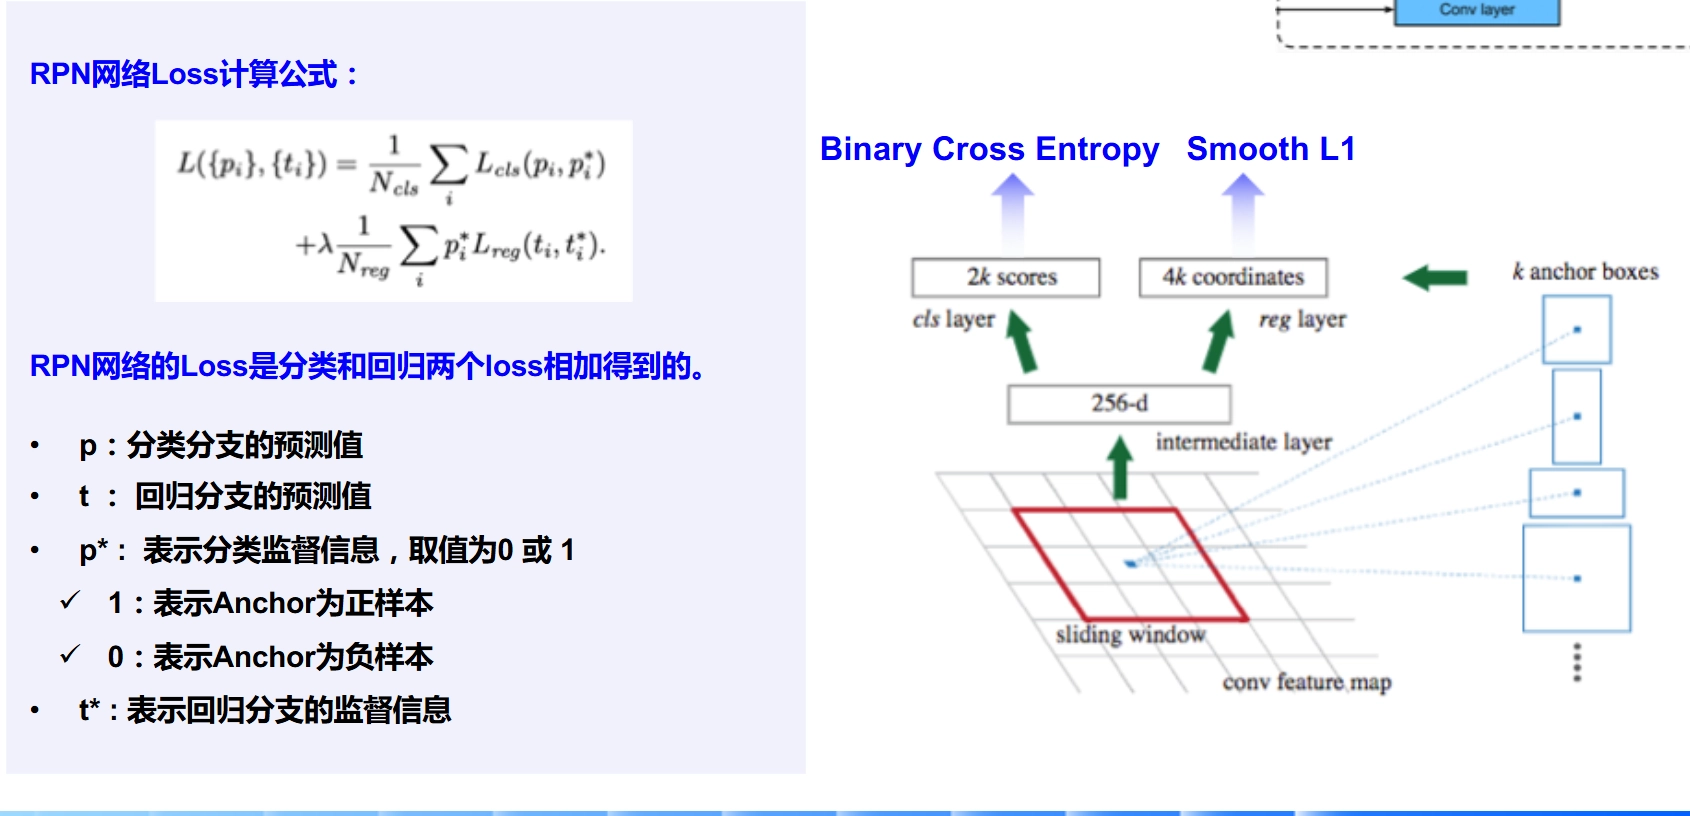
RPN的Loss怎么计算的#
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523232029651-1486104498.png)
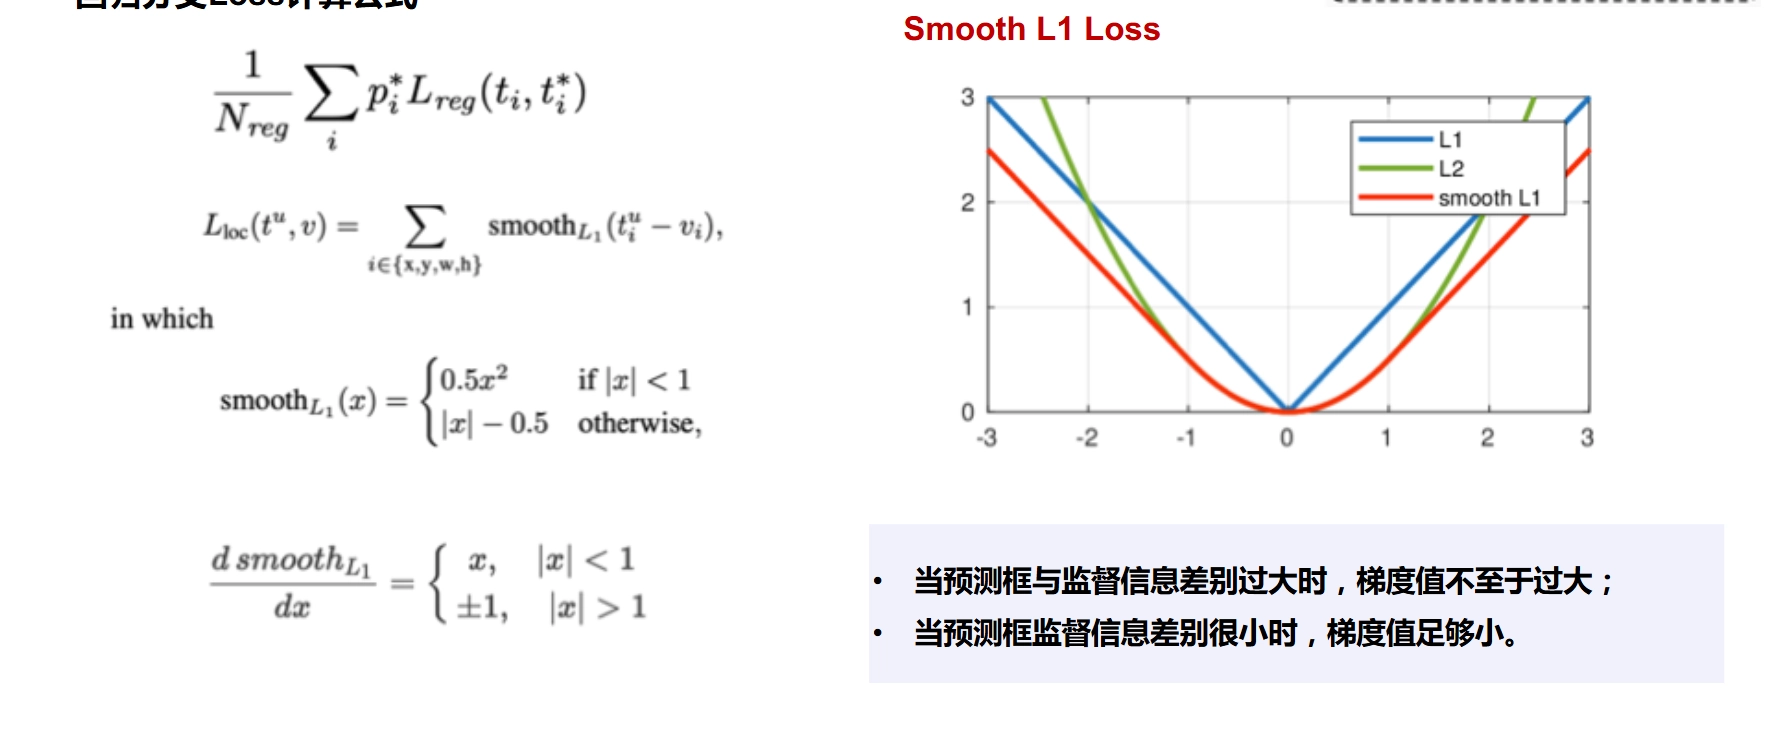
RPN网络回归分支Loss#
当预测框与监督信息差别过大时,梯度值不至于过大,
当预测框监督信息差别很小时,梯度值足够小。
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523232210716-1876208084.png)
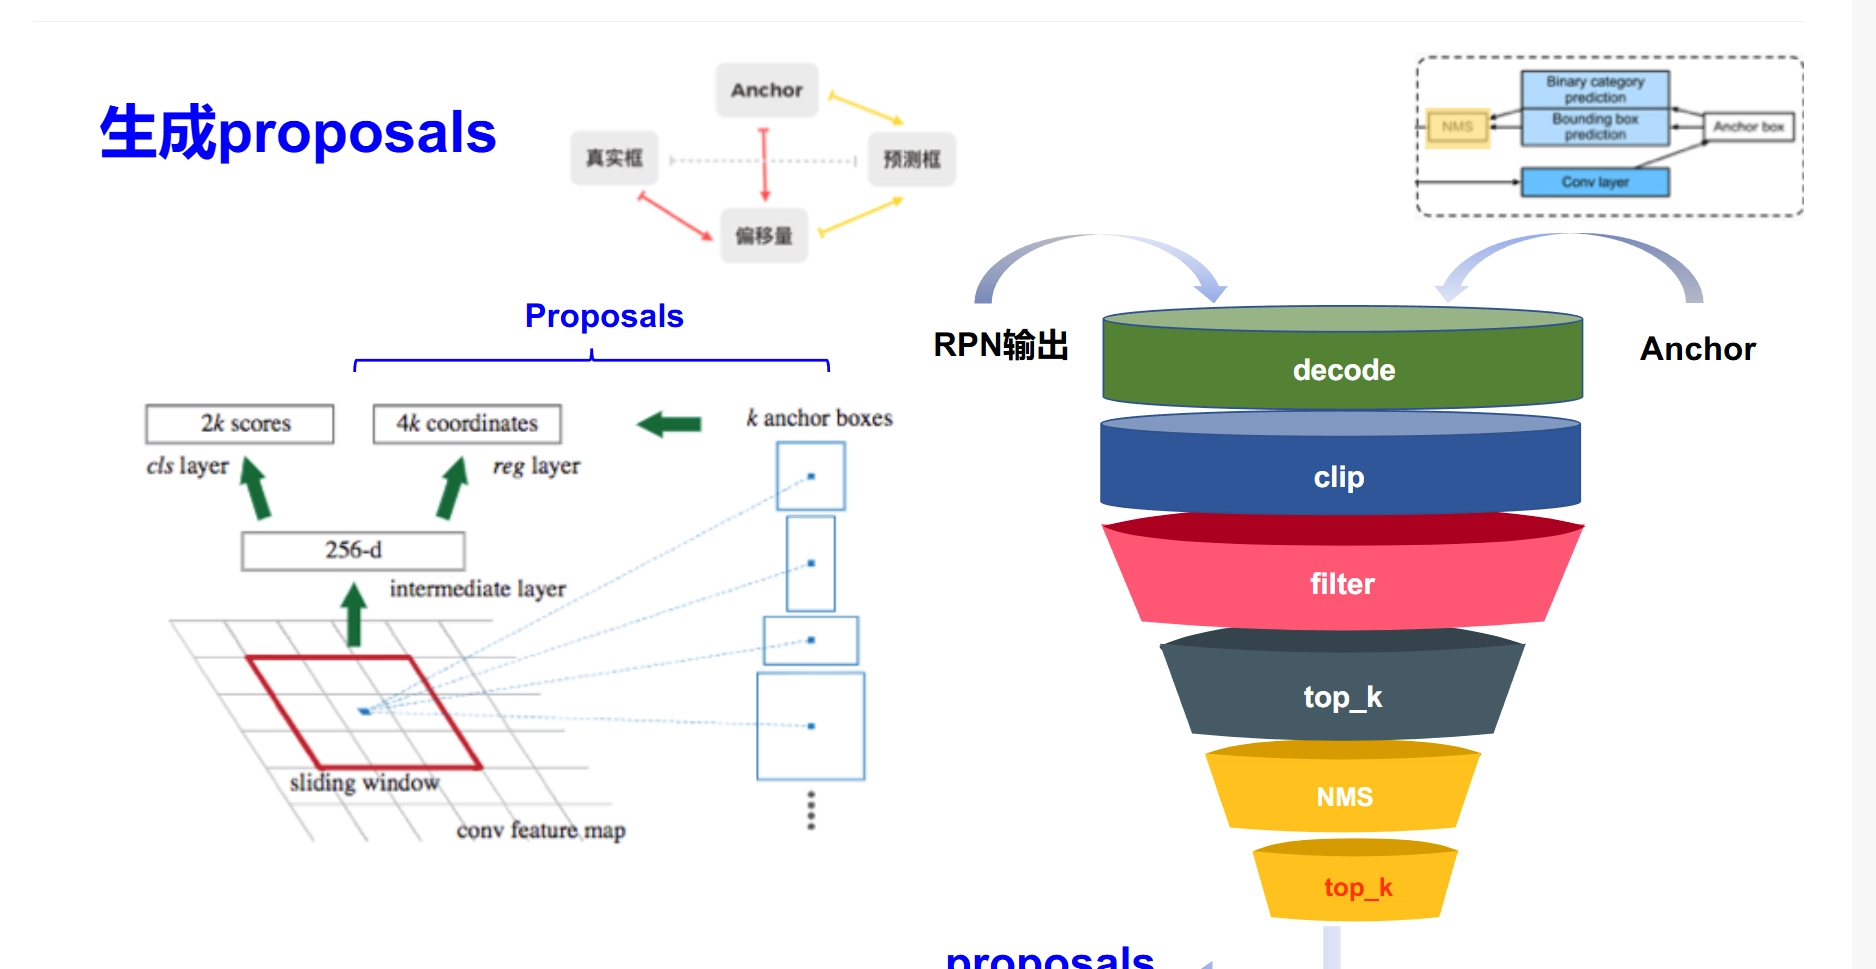
生成Proposal#
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523232239786-1228222459.png)
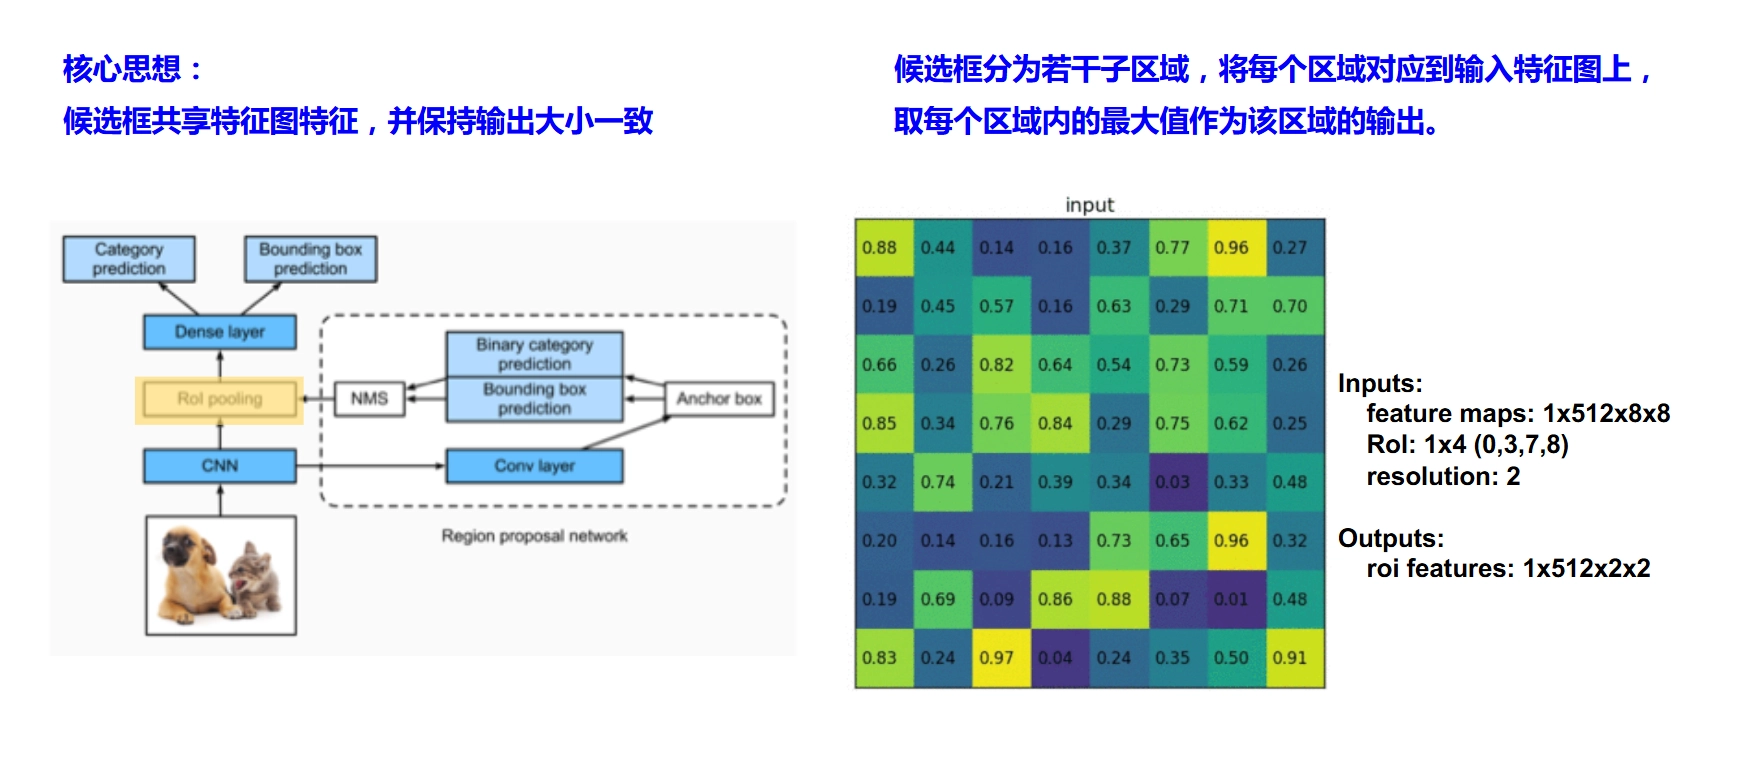
RoI Pooling#
核心思想:候选框共享特征图特征,并保持相同大小
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523232424382-1548260623.png)
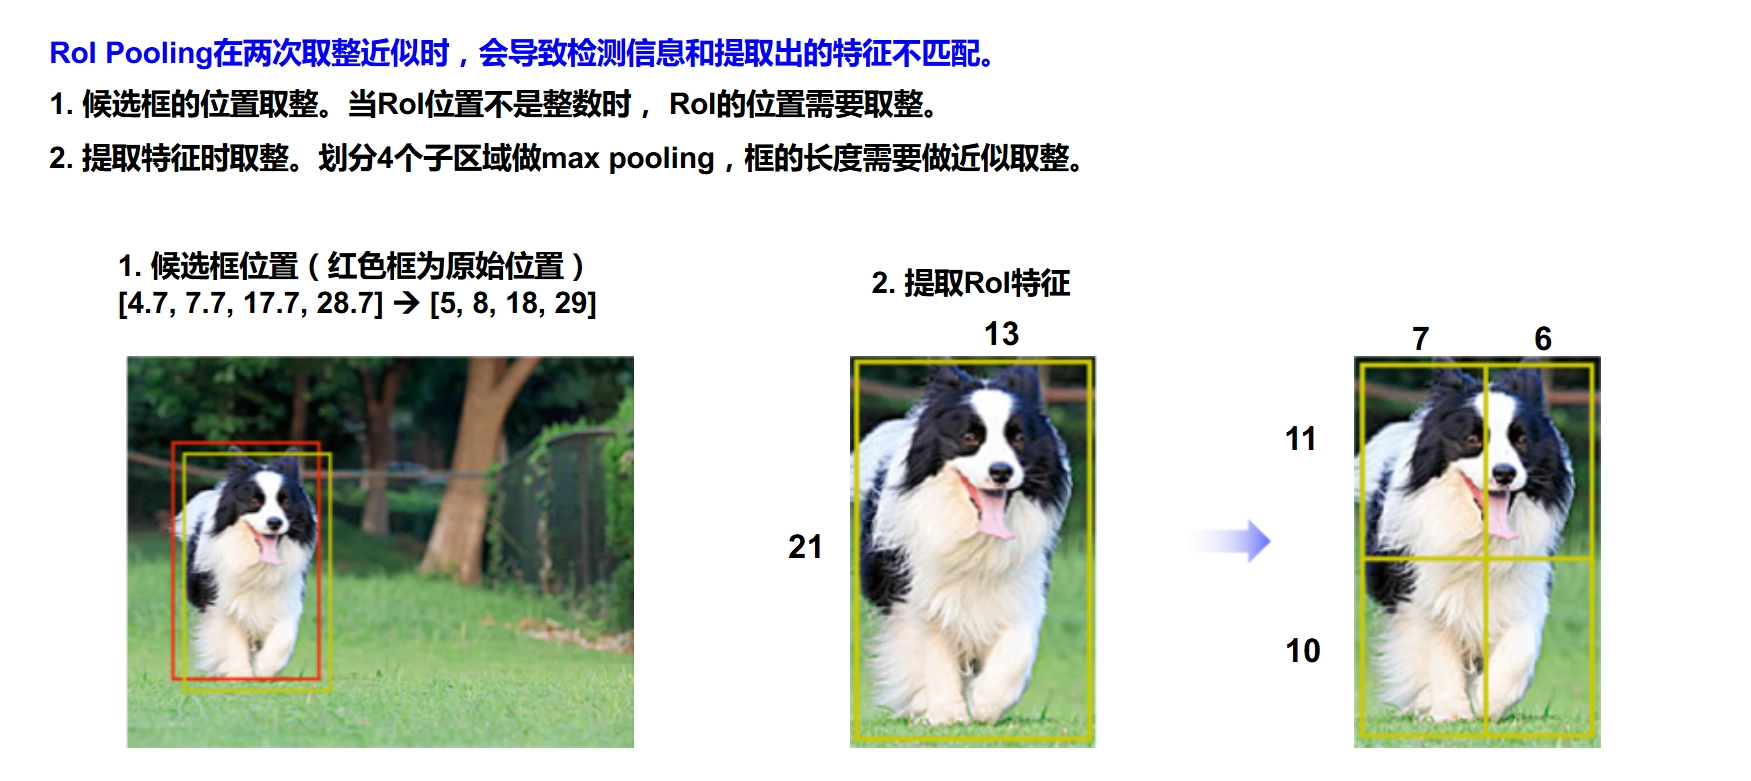
RoI Pooling的不足#
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523232537644-2106622071.png)
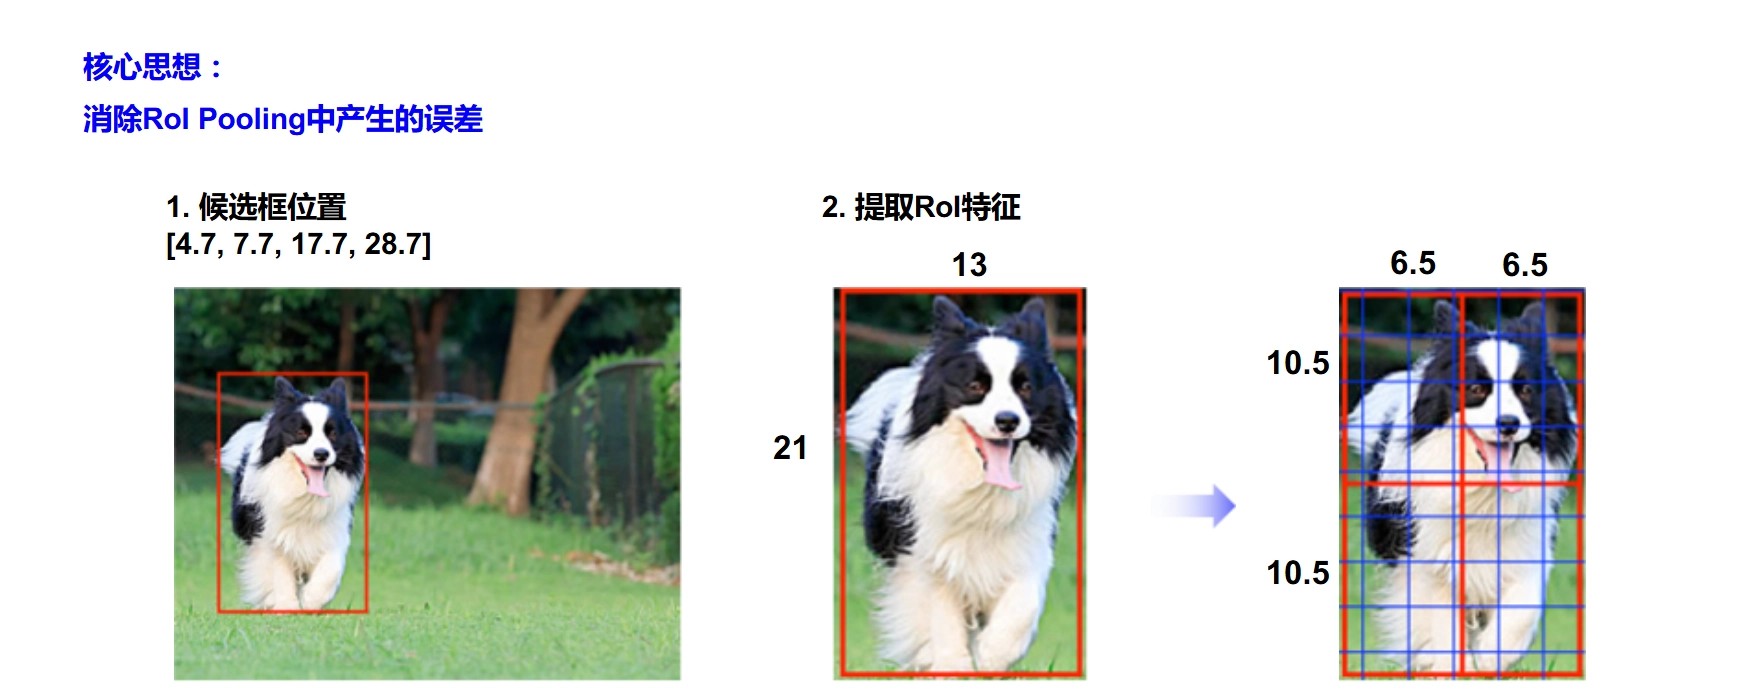
RoI Align#
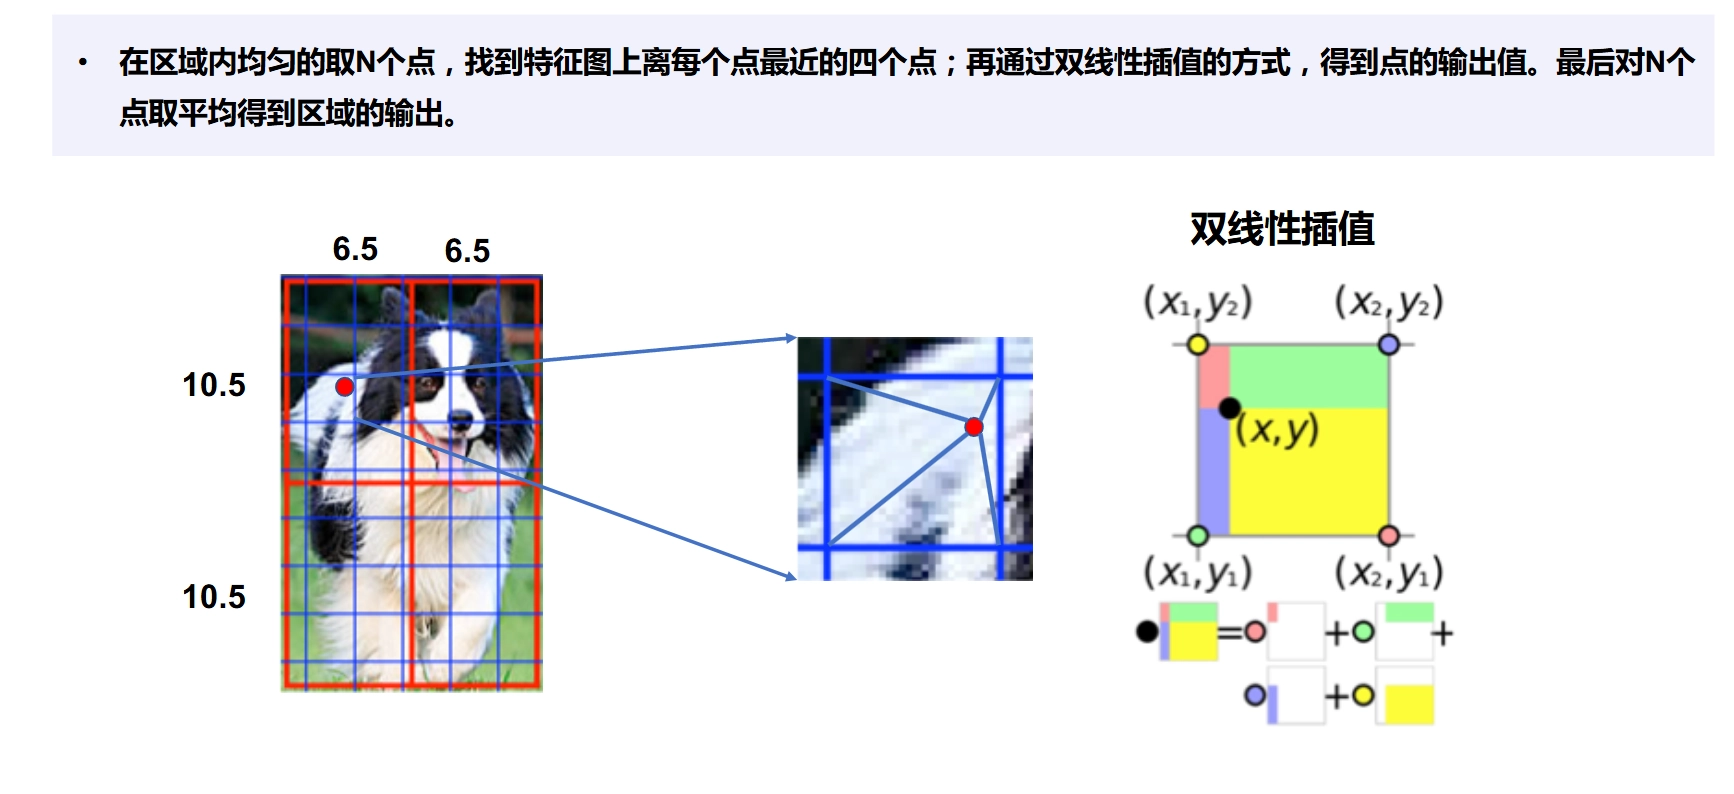
用来消除RoI在2次取整中产生的误差,区域内划分n个块,在每个块里面找到特征点以及离他最近的4个点,在通过双线插值的方式得到输出,对n个块进行操作求平均值就得到了整个区域的输出
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523232620660-551691763.png)
具体实现
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523232813464-1532657897.png)
BBox Head
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523233113626-1683549039.png)
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523233144740-1630510741.png)
BBoX Head中的监督信息#
[
](https://img2024.cnblogs.com/blog/3517150/202505/3517150-20250523233225172-825064430.png)
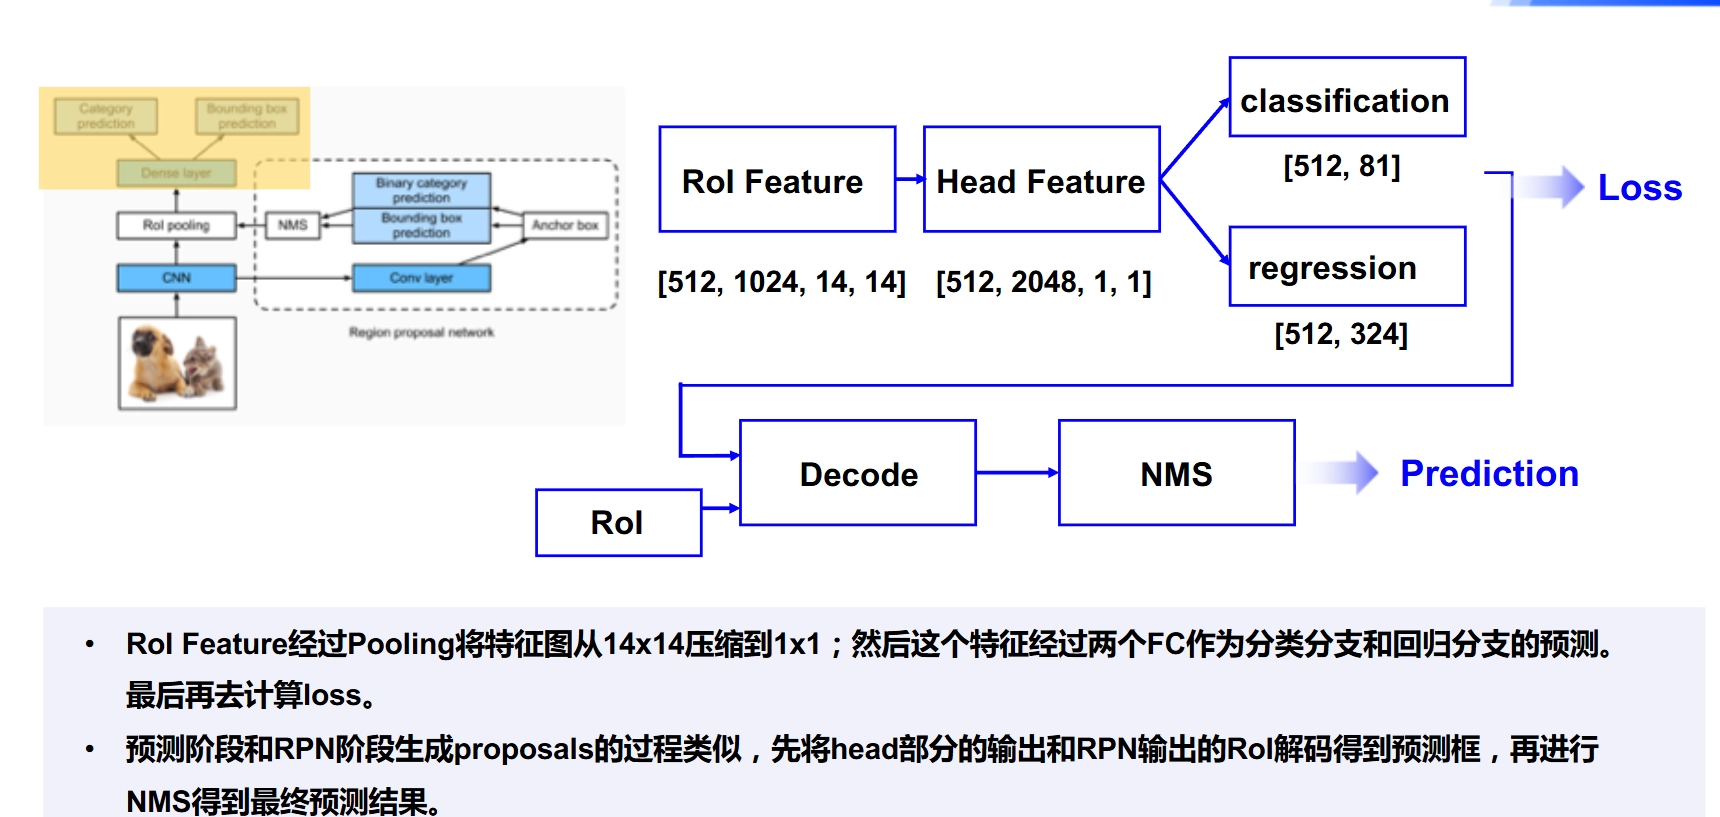
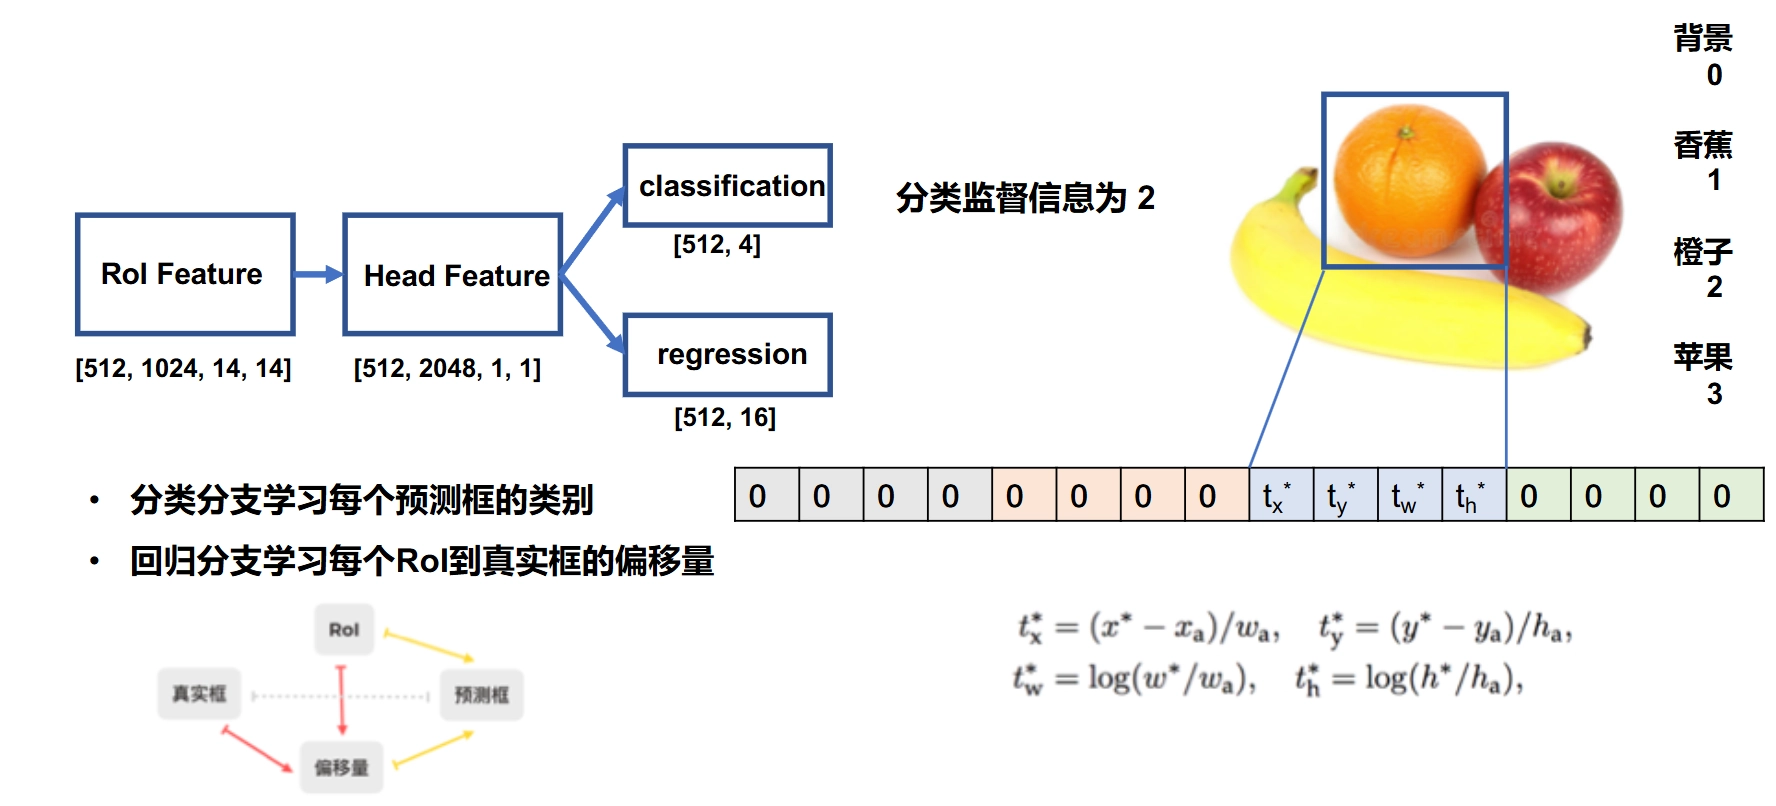
在目标检测任务中,Bounding Box Head(边界框头部 是模型的一个关键组成部分,负责预测目标的位置和尺寸(即边界框)。它的监督信息(即训练时的标签和损失函数)直接影响模型的定位精度。以下是关于 Bounding Box Head 监督信息的详细说明:
1. 监督信息的组成#
Bounding Box Head 的监督信息通常包括以下两部分:
- 边界框坐标:
- 通常用
(x, y, w, h)或(x1, y1, x2, y2)表示:
(x, y):边界框的中心坐标。
(w, h):边界框的宽度和高度。
(x1, y1, x2, y2):边界框的左上角和右下角坐标。
- 这些坐标是相对于图像或特征图的归一化值(如
[0, 1]范围)。
- 目标类别标签(可选):
- 如果 Bounding Box Head 同时负责分类任务(如 Faster R-CNN),则还需要类别标签(如
[0, 1, 0]表示“狗”)。
2. 监督信息的来源#
- 标注数据:来自数据集的标注文件(如 COCO 格式的
annotations.json)。
- 区域提议(如 Faster R-CNN):
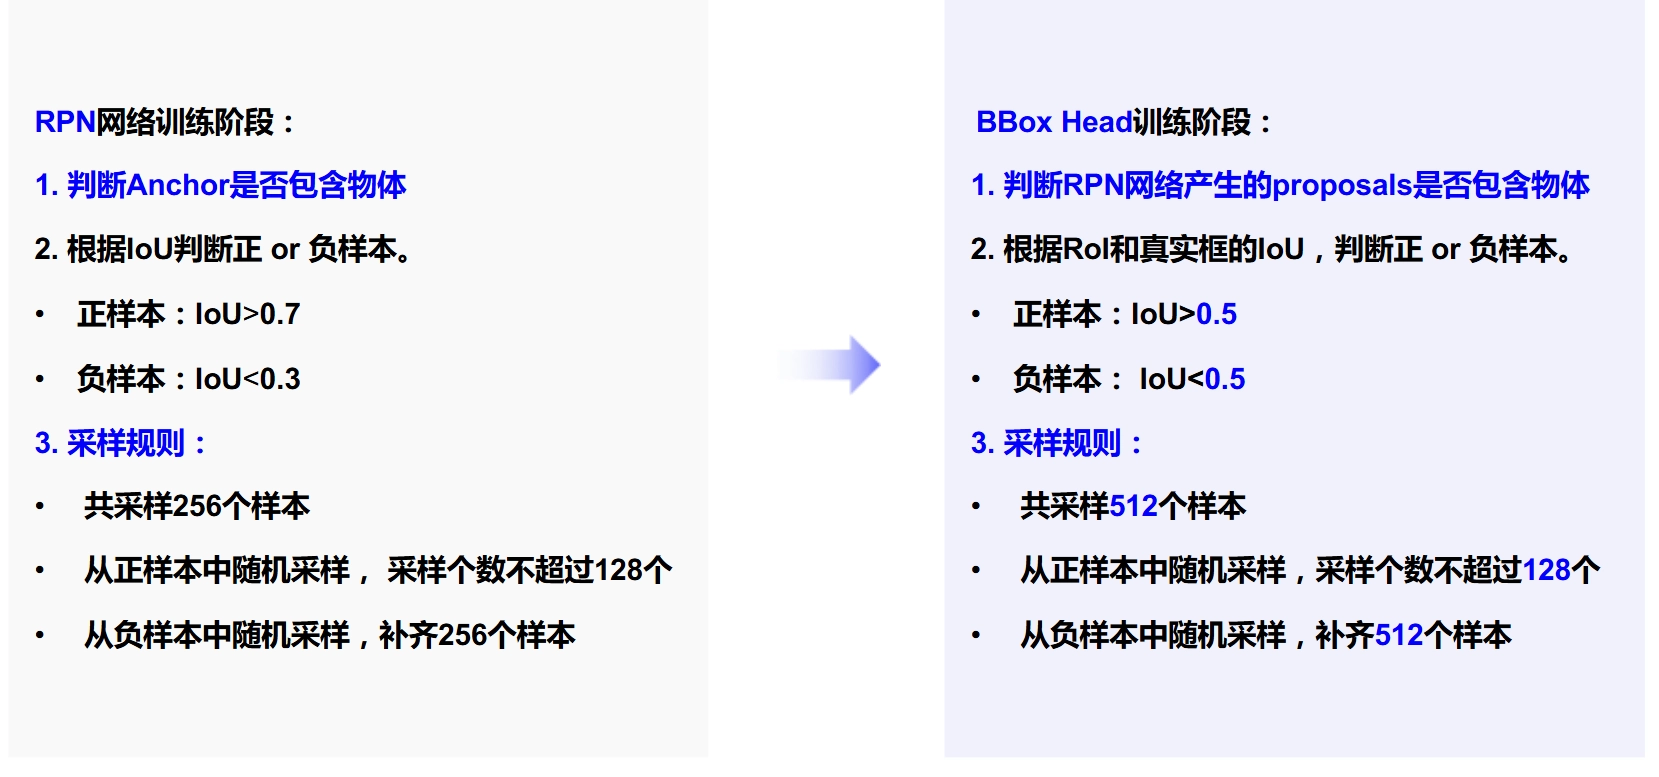
- 在训练时,RPN(Region Proposal Network)生成的候选框(Proposals)与真实框(Ground Truth)匹配后,为正样本分配边界框回归目标。
3. 损失函数#
Bounding Box Head 的监督信息通过损失函数指导模型优化。常用的损失函数包括:
- Smooth L1 Loss(Faster R-CNN):
- 用于边界框回归,对离群值(Outliers)更鲁棒。
- 公式:SmoothL1(x)={0.5x2if ∣x∣<1∣x∣−0.5otherwisetext{SmoothL1}(x) = begin{cases}
0.5x^2 & text{if } |x| < 1
|x| - 0.5 & text{otherwise}
end{cases}
SmoothL1(x)={0.5x2∣x∣−0.5if ∣x∣<1otherwise
- 其中
x是预测值与真实值的差。
- IoU Loss(如 UnitBox):
- 直接优化预测框与真实框的 IoU。
- 公式:IoU Loss=−ln(IoU)text{IoU Loss} = -ln(text{IoU})
IoU Loss=−ln(IoU)
- GIoU Loss / DIoU Loss(改进版):
- 解决 IoU Loss 在无重叠情况下的梯度消失问题。
4. 正负样本分配#
在训练时,需要为 Bounding Box Head 分配正负样本:
- 正样本:
- 与真实框 IoU 超过阈值(如 0.5)的候选框。
- 负责回归边界框坐标。
- 负样本:
- 与真实框 IoU 低于阈值(如 0.3)的候选框。
- 仅用于背景分类(不参与回归)。
5. 具体任务中的实现#
Faster R-CNN#
- 输入:RPN 生成的候选框(Proposals)。
- 监督信息:
- 正样本的边界框偏移量(Δx, Δy, Δw, Δh)。
- 类别标签(前景/背景 + 具体类别)。
- 损失函数:
- 分类:交叉熵损失。
- 回归:Smooth L1 Loss。
YOLO#
- 输入:网格单元(Grid Cells)的预测框。
- 监督信息:
- 直接回归
(x, y, w, h),并计算与真实框的损失(如 MSE Loss)。
RetinaNet#
- 输入:锚点框(Anchor Boxes)。
- 监督信息:
- 通过 Focal Loss 解决类别不平衡问题。
常见的 Bounding Box Loss 类型
1. L1 Loss(Mean Absolute Error, MAE)#
- 公式: L1=∑i=1n∣yi−y^i∣ L1 = sum_{i=1}^{n} |y_i - hat{y}_i| L1=i=1∑n∣yi−y^i∣
- 特点:
- 直接计算预测框和真实框坐标的绝对差值。
- 对异常值不敏感,但梯度恒定,可能导致收敛速度较慢。
2. L2 Loss(Mean Squared Error, MSE)#
- 公式: L2=∑i=1n(yi−y^i)2 L2 = sum_{i=1}^{n} (y_i - hat{y}_i)^2 L2=i=1∑n(yi−y^i)2
- 特点:
- 计算预测框和真实框坐标的平方差。
- 对异常值敏感,梯度随着误差增大而增大,可能导致训练不稳定。
3. Smooth L1 Loss#
- 公式:Smooth L1={0.5(yi−y^i)2if ∣yi−y^i∣<1∣yi−y^i∣−0.5otherwisetext{Smooth L1} =
begin{cases}
0.5(y_i - hat{y}_i)^2 & text{if } |y_i - hat{y}_i| < 1
|y_i - hat{y}_i| - 0.5 & text{otherwise}
end{cases}
Smooth L1={0.5(yi−y^i)2∣yi−y^i∣−0.5if ∣yi−y^i∣<1otherwise
- 特点:
- 结合了 L1 和 L2 的优点,对异常值不敏感且梯度稳定。
- 常用于 Faster R-CNN 等目标检测模型。
4. IoU Loss(Intersection over Union Loss)#
- 公式: IoU Loss=1−IoU text{IoU Loss} = 1 - text{IoU} IoU Loss=1−IoU
- 特点:
- 直接优化预测框和真实框的交并比(IoU)。
- 对框的尺度不敏感,但无法处理不相交的框(IoU=0 时梯度为 0)。
5. GIoU Loss(Generalized IoU Loss)#
- 公式: GIoU Loss=1−GIoU text{GIoU Loss} = 1 - text{GIoU} GIoU Loss=1−GIoU
- 特点:
- 解决了 IoU Loss 在不相交框时的梯度问题。
- 通过引入最小闭合框(最小包围框)来优化 IoU。
6. DIoU Loss(Distance IoU Loss)#
- 公式: [ text{DIoU Loss} = 1 - text{IoU} + frac{rho^2(b, b{gt})}{c2} ]
- 其中,ρrhoρ 是预测框和真实框中心点的欧氏距离,ccc 是最小闭合框的对角线长度。
- 特点:
- 同时考虑 IoU 和中心点距离,收敛更快。
7. CIoU Loss(Complete IoU Loss)#
- 公式: [ text{CIoU Loss} = 1 - text{IoU} + frac{rho^2(b, b{gt})}{c2} + alpha v ]
- 其中,vvv 是长宽比的相似性度量,αalphaα 是权重系数。
- 特点:
- 在 DIoU 的基础上增加了长宽比的约束,进一步优化框的回归。
8. Focal Loss for Bounding Box#
- 特点:
- 类似于分类任务中的 Focal Loss,用于解决难易样本不平衡问题。
- 对难样本赋予更高的权重。
值得一提的是Faster RCNN采用的是Smooth L1 Loss、
总结一下BBox的网络结构和训练方法:
BBox 的网络结构与训练方法总结#
网络结构#
- Backbone(如 ResNet、EfficientNet):提取图像特征。
- Neck(如 FPN、PANet):多尺度特征融合,增强小目标检测。
- Head(如 RPN、YOLO Head):生成预测框和类别。
- Loss 模块:计算分类(Cross-Entropy)和回归(如 GIoU Loss)损失。
训练方法#
- Anchor-based(如 Faster R-CNN):预设锚框,通过 IoU 匹配正负样本。
- Anchor-free(如 CenterNet):直接预测中心点和尺寸。
- 数据增强(如 Mosaic、MixUp):提升泛化能力。
- 优化策略:SGD/AdamW,学习率衰减,多任务损失平衡。
核心目标:优化框的位置(回归)和类别(分类)。
PaddleDetection Faster R-CNN Github地t址:
评论加载中…