语义分割(semanticsegmentation)
是
计算机视觉
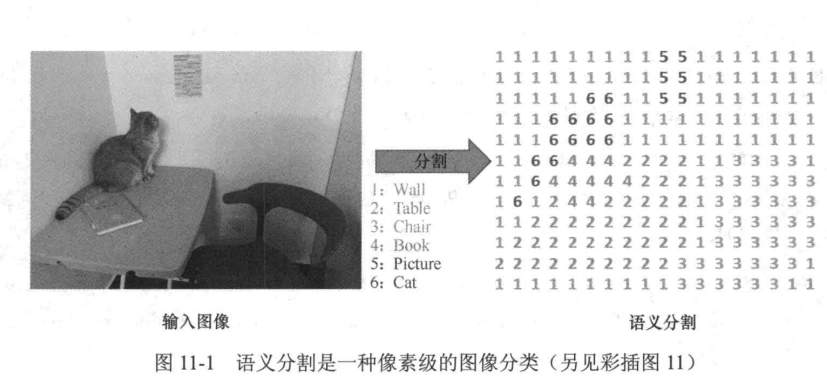
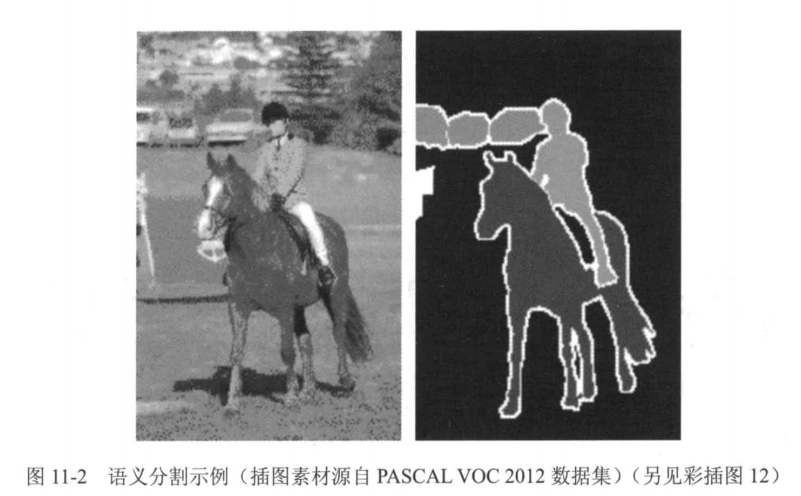
领域的一个基础问题,也是一项具有挑战性的视觉识别任务。简单来说,语义分割的目标是为一幅图像的每个像素预测一个标签,可以说它是一种像素级的“图像分类”,如图11-1所示。需要注意的是,与在第9章中介绍的无监督图像分割不同,语义分割得到的分割是具有语义性的,每个分割对应于给定的标注集中的一个类别。如图11-2所示,其中粉红色和玫红色的分割分别对应于“人”和“马”这两个类别。语义分割能够提供像素级的类别信息,因此在实际场景中有很多应用,如自动驾驶、缺陷检测、医学影像辅助诊断等。
用于语义分割评测的标准数据集
主要有如下3个。
(1)PASCALVOC:PASCALVOC数据集是PASCALVOC挑战赛官方使用的数据集。该数据集包含20类约1万幅图像,每幅图像都有完整的标签。
(2)
Cityscapes
:Cityscapes数据集采集自德国及其邻国的50个城市,包括了春、夏、秋 3个季节的街区场景。该数据集分为两卷,其中一卷包含5000幅带有高质量像素级标签的图像,共有19个类别。
(3)
ADE20K
:ADE20K数据集是MIT发布的场景理解数据集,包含2万多幅标记完整的图像,共超过3000个类别。
在语义分割中,通常采用平均交并比(meanintersectionoverunion,mloU)作为评测指标。令c表示真实类别,I表示预测类别(c,l∈C),则mIoU定义如下:
对于单个类别,IoU 的计算公式为:
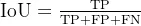
- TP(True Positive):正确预测为正类的像素数量。
- FP(False Positive):错误预测为正类的像素数量。
- FN(False Negative):错误预测为负类的像素数量。
mIoU 的计算方法
- 逐类别计算 IoU
对每个类别分别计算 IoU,忽略其他类别。
- 全局平均
将所有类别的 IoU 相加,除以类别总数:
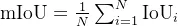
其中 N 为类别数量,

为第 i个类别的 IoU。
全卷积网络
我们可以训练一个对每个像素进行分类的CNN model,but
上述的方法虽然直观,但在实际中却存在许多问题。
(1)由于一幅图像中可能存在成千上万像素,且相邻像素的图像块有大部分重叠,使得这一方法计算量大、计算效率低。
(2)与整幅图像相比,图像块显得比较小,而且只能提取图像局部的特征,这使得分类的生能受限。
(3)整个过程不是端到端的,它需要有预处理和后处理的环节。
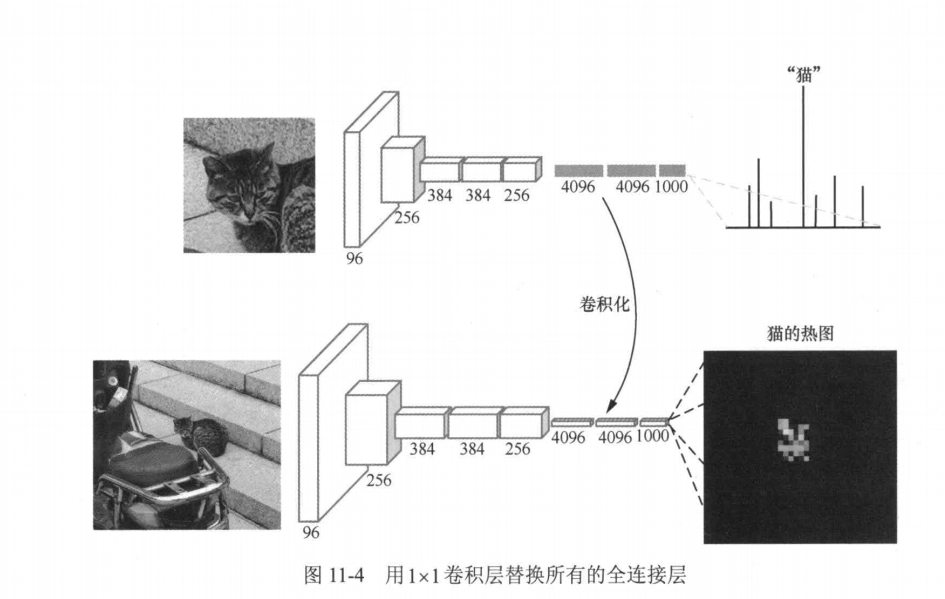
为了应对这些问题,2015年JonathanLong等人提出了一种全新的分割网络一全卷积网络(fullyconvolutionalnetwork,FCN)。与传统的CNN网络(如AlexNet等)不同,在FCN中,网络输出的全连接层被替换为卷积核大小为1x1的卷积层,如图11-4所示。根据第10章的内容,对于图像分类,可以使用全连接层将卷积层输出的多通道图像特征图映射成一个维度为 C 的向量,该向量中每个元素的值表示属于对应类别的置信度,如此便可以实现一幅图像的分类。然而在语义分割中,需要对一幅图像的每个像素进行分类,因此全连接层并不适用。为了实现端到端的预测,使用一个1x1卷积层替换全连接层,将卷积层输出的多通道特征图映射成一个空间分辨率不变的通道数为C的类别置信度图。这样,卷积层输出的特征图上的每个空间位置都对应一个维度为C的向量,表示该位置对应的原图区域属于C中每个类别的置信度,如此便可
实现图像
的语义分割。我们把类别置信度图叫作热图(heatmap),属于某类的置信度越高,热度就越高。调整热图的空间分辨率,使其和原图一致,便可以得到所需的语义分割的结果。不过,在图11-4中依旧可以发现两个明显的问题:随着卷积的进行,特征图越来越小,最终输出的热图要比原图小很多:由于最终输出的热图较小,其蕴含的边界信息也变得十分的粗糙,无法精准地勾勒出原图中物体的轮廓。为了解决上述两个问题,FCN网络引入了两种有效的架构:上采样(upsampling)和跳跃连接(skip-connection)。
上采样
为了解决热图分辨率较小的问题,使用上采样可以实现和原图分辨率保持一致。上采样一般通过双线性插值法实现
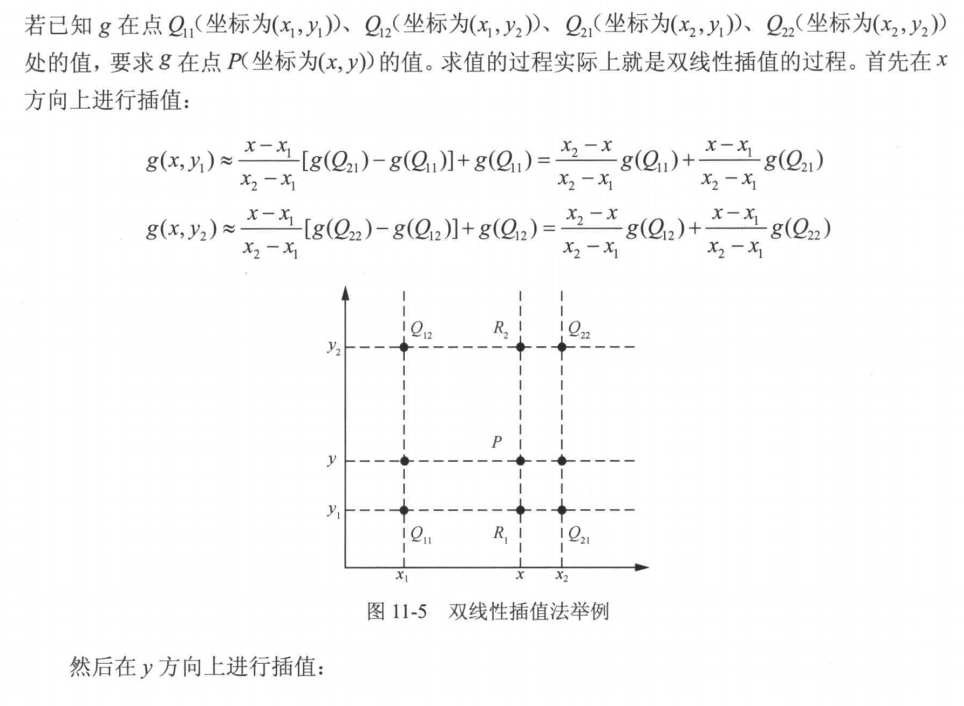
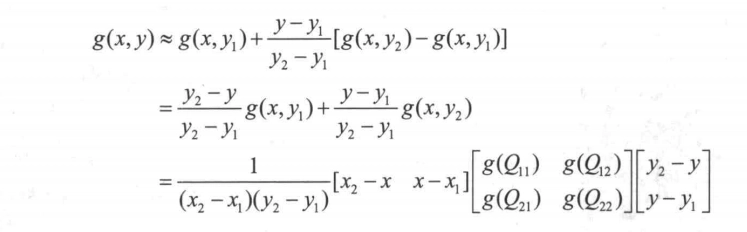
如此,便可以求出点P的值。
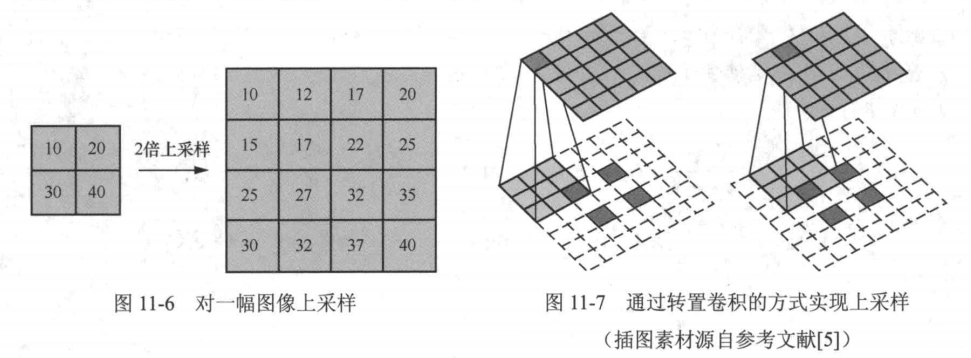
可以发现,双线性插值其实就是在两个方向上分别进行插值,而每个方向的“插值”过程类似于计算一个线性函数在某一点的函数值的过程。当我们学会了双线性插值之后,便可以对一幅分辨率为2像素×2像素的图像上采样,将其分辨率变为4像素×4像素,如图11-6所示。
观察上述数学形式,可以发现双线性插值可以通过卷积实现。因此可以用深度网络中的卷积层实现特征图的上采样,只是这个卷积层的卷积核是固定的。那么是否可以用可学习的卷积核来实现特征图上采样呢?当然也是可以的。这种可学习的卷积称为转置卷积或反卷积,是一个步长小于1的卷积。实际上,当卷积的步长s<1时,对图像进行卷积相当于在图像的相邻像素间插入1-1个零再进行步长为1的卷积。如图11-7所示,对输入图像做步长为0.5的卷积实 S现对其上采样:
首先要在图像的每两个相邻像素间插入一个值为零的像素,并在边界以2像素×2像素补零;然后,对其做步长为1,卷积核为3×3的卷积。最终将图像从2像素×2像素上采样到5像素×5像素。在实际操作中,对特征图的每个通道依次进行上采样,得到最终的结果。
跳跃连接
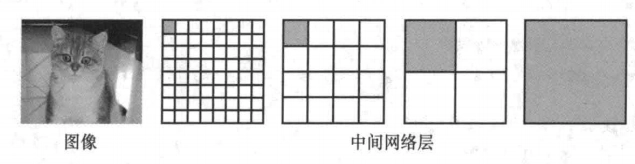
对于传统的分类网络,由于主干网最后一层输出的特征图空间分辨率太低(如图11-4),上采样之后预测得到的标签图会很粗糙,无法精准地勾勒出原图中物体的轮廓。一般情况下,浅层卷积层的特征图较大,能够精确定位物体的边界,但是语义性不够:深层卷积层的特征图较小,但是语义性强。有什么办法在得到较大的特征图的同时,也能使特征图拥有丰富的语义信息呢?FCN通过跳跃连接将网络中不同层级的卷积层特征融合,解决了该问题。如图11-8
具体而言,如图11-9所示
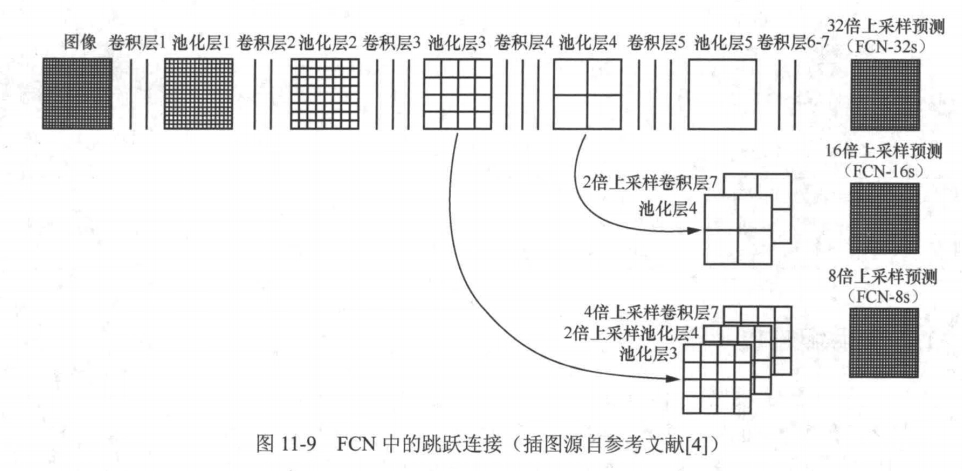
从FCN的主干网络可以得到空间分辨率分别是原图1/2、1/4、 1/8、1/16和1/32的5个特征图。连接特征图的方式有多种,根据连接的特征图层级的不同, FCN有不同的变种,包括FCN-8s、FCN-16s和FCN-32s。不同层级的特征图不但空间分辨率不一样,通道数也不一样,因此在对它们进行连接时,需要先将它们的通道数调整成一致。如何在不改变特征图的空间分辨率的情况下改变特征图的通道数?没错,我们刚刚介绍过的1×1卷积正好可以实现这个功能。我们用1×1卷积将不同层级的特征图的通道数都调整为C1。对于主干网络池化层5(pool5)输出的特征图,在通过1×1卷积调整完通道数后,直接对其进行32倍上采样,得到与原图相同空间分辨率的特征图,这样的模型被称为FCN-32s;我们也可以将主干网络池化层5输出的特征图进行2倍上采样后,与主干网络池化层4(pool4)输出的特征图进行逐元素相加(element-wise sum),再将相加后的特征图进行l6倍上采样,得到与原图相同空间分辨率的特征图,这样的
模型
被称为FCN-16s:同样,我们还可以将上述相加后的特征图先进行2倍上采样,然后与主干网络池化层3(oo3)输出的特征图逐元素相加得到新的特征图,再将这个特征图进行8倍上采样,得到与原图相同空间分辨率的特征图,这样的模型被称为FCN-8s。
现在总结一下用FCN进行语义分割的流程
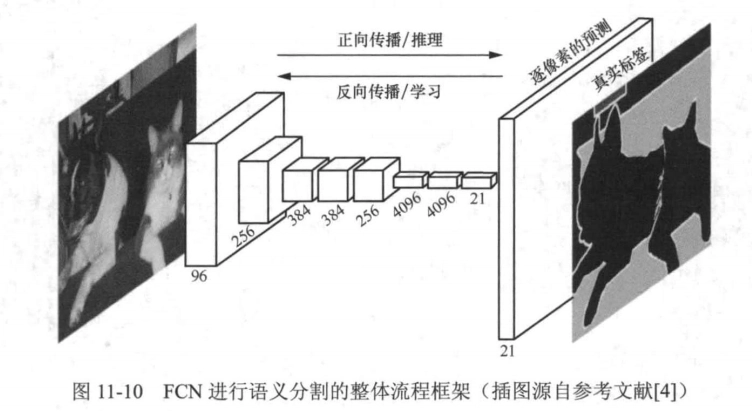
首先利用主干网络对图像进行特征提取,主干网络的不同层级可以输出空间分辨率不同的特征图;然后用1×1的卷积层将不同层级的特征图的通道数调整为C;接着用跳跃连接融合不同层级的特征图,并通过上采样将特征图的空间分辨率增大到与原图一致;最后基于上采样后的特征图进行逐像素的类别预测。FCN进行语义分割的整体流程框架如图11-10所示。
FCN代码实现
训练代码
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as T
from torchvision.datasets import VOCSegmentation
from torch.utils.data import DataLoader
import numpy as np
from PIL import Image
import os

# -------------------
# 1. 配置
# -------------------
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
NUM_CLASSES = 21  # VOC2012: 20类 + 背景
BATCH_SIZE = 4 # 批大小
EPOCHS = 20  # 训练轮数
LR = 1e-4  # 学习率
# 应该是 VOCdevkit 的父目录,注意!即不包含 VOCdevkit 的目录
DATA_DIR = "/home/hllqk/projects/dive-into-deep-learning/Hands-on-learning-computer-vision/"

# VOC 官方调色板(21类)
VOC_COLORMAP = [
(0, 0, 0),        # 背景
(128, 0, 0),      # aeroplane
(0, 128, 0),      # bicycle
(128, 128, 0),    # bird
(0, 0, 128),      # boat
(128, 0, 128),    # bottle
(0, 128, 128),    # bus
(128, 128, 128),  # car
(64, 0, 0),       # cat
(192, 0, 0),      # chair
(64, 128, 0),     # cow
(192, 128, 0),    # diningtable
(64, 0, 128),     # dog
(192, 0, 128),    # horse
(64, 128, 128),   # motorbike
(192, 128, 128),  # person
(0, 64, 0),       # potted plant
(128, 64, 0),     # sheep
(0, 192, 0),      # sofa
(128, 192, 0),    # train
(0, 64, 128)      # tv/monitor
]

# -------------------
# 2. 数据集
# -------------------
class VOCSegDataset(VOCSegmentation):
def __init__(self, root, year, image_set, transforms_img=None, transforms_mask=None):
super().__init__(root=root, year=year, image_set=image_set, download=False) # 允许下载VOC2012数据集
self.transforms_img = transforms_img
self.transforms_mask = transforms_mask

def __getitem__(self, index):
img, target = super().__getitem__(index)
if self.transforms_img:
img = self.transforms_img(img)
if self.transforms_mask:
target = self.transforms_mask(target)
return img, target

# 图像变换
train_img_tf = T.Compose([
T.Resize((256, 256)),          # 调整图像大小
T.ToTensor(),                  # 转为张量并归一化到 [0, 1]
T.Normalize(                   # 标准化(基于ImageNet统计量)
mean=[0.485, 0.456, 0.406],
std=[0.229, 0.224, 0.225]
)
])
train_mask_tf = T.Compose([
T.Resize((256, 256), interpolation=Image.NEAREST),  # 最近邻插值(避免引入无效类别)
T.PILToTensor()                                     # 转为张量(保持整数标签)
])

train_set = VOCSegDataset(DATA_DIR, year="2012", image_set="train",
transforms_img=train_img_tf,
transforms_mask=train_mask_tf)
val_set = VOCSegDataset(DATA_DIR, year="2012", image_set="val",
transforms_img=train_img_tf,
transforms_mask=train_mask_tf)

train_loader = DataLoader(train_set, batch_size=BATCH_SIZE, shuffle=True, num_workers=4)
val_loader = DataLoader(val_set, batch_size=1, shuffle=False)

# -------------------
# 3. FCN 网络 (基于 VGG16)
# -------------------
class FCN8s(nn.Module):
def __init__(self, num_classes):
super(FCN8s, self).__init__()
vgg = torchvision.models.vgg16(pretrained=True)
features = list(vgg.features.children())

self.stage1 = nn.Sequential(*features[:17])  # 到 pool3
self.stage2 = nn.Sequential(*features[17:24]) # 到 pool4
self.stage3 = nn.Sequential(*features[24:])   # 到 pool5

self.score_pool3 = nn.Conv2d(256, num_classes, kernel_size=1)
self.score_pool4 = nn.Conv2d(512, num_classes, kernel_size=1)

self.score_final = nn.Conv2d(512, num_classes, kernel_size=1)

self.upsample_2x = nn.ConvTranspose2d(num_classes, num_classes, 4, stride=2, padding=1, bias=False)
self.upsample_8x = nn.ConvTranspose2d(num_classes, num_classes, 16, stride=8, padding=4, bias=False)

def forward(self, x):
pool3 = self.stage1(x)
pool4 = self.stage2(pool3)
pool5 = self.stage3(pool4)

score_pool3 = self.score_pool3(pool3)
score_pool4 = self.score_pool4(pool4)
score_final = self.score_final(pool5)

upscore2 = self.upsample_2x(score_final)  # x2
fuse_pool4 = upscore2 + score_pool4
upscore_pool4 = self.upsample_2x(fuse_pool4)  # x2
fuse_pool3 = upscore_pool4 + score_pool3
out = self.upsample_8x(fuse_pool3)  # x8

return out

# -------------------
# 4. 训练
# -------------------
model = FCN8s(NUM_CLASSES).to(DEVICE)
criterion = nn.CrossEntropyLoss(ignore_index=255)  # VOC 标签中 255 表示忽略
optimizer = optim.Adam(model.parameters(), lr=LR)

best_val_loss = float("inf")  # 记录最佳模型

# 将预测结果转换为 VOC 彩色图
def decode_segmap(mask):
r = np.zeros_like(mask, dtype=np.uint8)
g = np.zeros_like(mask, dtype=np.uint8)
b = np.zeros_like(mask, dtype=np.uint8)
for l in range(NUM_CLASSES):
idx = mask == l
r[idx], g[idx], b[idx] = VOC_COLORMAP[l]
return np.stack([r, g, b], axis=2)

def train():
global best_val_loss
for epoch in range(EPOCHS):
model.train()
total_loss = 0
for imgs, masks in train_loader:
imgs = imgs.to(DEVICE)
masks = masks.squeeze(1).long().to(DEVICE)

optimizer.zero_grad()
outputs = model(imgs)
loss = criterion(outputs, masks)
loss.backward()
optimizer.step()

total_loss += loss.item()

train_loss = total_loss / len(train_loader)
val_loss = validate(epoch)

print(f"Epoch [{epoch+1}/{EPOCHS}]  Train Loss: {train_loss:.4f}  Val Loss: {val_loss:.4f}")

# 保存最佳模型
if val_loss < best_val_loss:
best_val_loss = val_loss
torch.save(model.state_dict(), "best_model.pth")
print(f" 保存最佳模型 (Val Loss: {best_val_loss:.4f})")

def validate(epoch):
model.eval()
total_val_loss = 0
with torch.no_grad():
for i, (imgs, masks) in enumerate(val_loader):
imgs = imgs.to(DEVICE)
masks = masks.squeeze(1).long().to(DEVICE)
outputs = model(imgs)
loss = criterion(outputs, masks)
total_val_loss += loss.item()

if i == 0:  # 保存第一个batch的预测图
preds = outputs.argmax(1).cpu().numpy()[0]
color_pred = decode_segmap(preds)
Image.fromarray(color_pred).save(f"pred_epoch{epoch}.png")
return total_val_loss / len(val_loader)

if __name__ == "__main__":
train()
为了简单没有实现双线性插值,你们可以直接尝试一下
使用双线性改动的好处
- 参数更少:
ConvTranspose2d被替换为无参数的插值运算。
- 稳定性更好:避免了转置卷积的棋盘效应。
- 推理速度更快:双线性插值是纯运算,不需要额外学习权重。
预测代码
import torch
import torchvision
from PIL import Image
import numpy as np
import matplotlib.pyplot as plt
from torchvision.datasets import VOCSegmentation
from torchvision import transforms as T
import torch.nn as nn

# -------------------
# 配置
# -------------------
DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
NUM_CLASSES = 21
DATA_DIR = "/home/hllqk/projects/dive-into-deep-learning/Hands-on-learning-computer-vision/"

VOC_COLORMAP = [
(0, 0, 0), (128, 0, 0), (0, 128, 0), (128, 128, 0), (0, 0, 128),
(128, 0, 128), (0, 128, 128), (128, 128, 128), (64, 0, 0), (192, 0, 0),
(64, 128, 0), (192, 128, 0), (64, 0, 128), (192, 0, 128), (64, 128, 128),
(192, 128, 128), (0, 64, 0), (128, 64, 0), (0, 192, 0), (128, 192, 0),
(0, 64, 128)
]
class FCN8s(nn.Module):
def __init__(self, num_classes):
super(FCN8s, self).__init__()
vgg = torchvision.models.vgg16(pretrained=True)
features = list(vgg.features.children())

self.stage1 = nn.Sequential(*features[:17])  # 到 pool3
self.stage2 = nn.Sequential(*features[17:24]) # 到 pool4
self.stage3 = nn.Sequential(*features[24:])   # 到 pool5

self.score_pool3 = nn.Conv2d(256, num_classes, kernel_size=1)
self.score_pool4 = nn.Conv2d(512, num_classes, kernel_size=1)

self.score_final = nn.Conv2d(512, num_classes, kernel_size=1)

self.upsample_2x = nn.ConvTranspose2d(num_classes, num_classes, 4, stride=2, padding=1, bias=False)
self.upsample_8x = nn.ConvTranspose2d(num_classes, num_classes, 16, stride=8, padding=4, bias=False)

def forward(self, x):
pool3 = self.stage1(x)
pool4 = self.stage2(pool3)
pool5 = self.stage3(pool4)

score_pool3 = self.score_pool3(pool3)
score_pool4 = self.score_pool4(pool4)
score_final = self.score_final(pool5)

upscore2 = self.upsample_2x(score_final)  # x2
fuse_pool4 = upscore2 + score_pool4
upscore_pool4 = self.upsample_2x(fuse_pool4)  # x2
fuse_pool3 = upscore_pool4 + score_pool3
out = self.upsample_8x(fuse_pool3)  # x8

return out

# -------------------
# 数据集类
# -------------------
class VOCSegDataset(VOCSegmentation):
def __init__(self, root, year, image_set, transforms_img=None, transforms_mask=None):
super().__init__(root=root, year=year, image_set=image_set, download=False)
self.transforms_img = transforms_img
self.transforms_mask = transforms_mask

def __getitem__(self, index):
img, target = super().__getitem__(index)
if self.transforms_img:
img = self.transforms_img(img)
if self.transforms_mask:
target = self.transforms_mask(target)
return img, target

# 图像变换
val_img_tf = T.Compose([
T.Resize((256, 256)),
T.ToTensor(),
T.Normalize(mean=[0.485,0.456,0.406], std=[0.229,0.224,0.225])
])
val_mask_tf = T.Compose([
T.Resize((256, 256), interpolation=Image.NEAREST),
T.PILToTensor()
])

val_set = VOCSegDataset(DATA_DIR, year="2012", image_set="val",
transforms_img=val_img_tf, transforms_mask=val_mask_tf)

# -------------------
# 加载模型
# -------------------
model = FCN8s(NUM_CLASSES).to(DEVICE)
model.load_state_dict(torch.load("best_model.pth", map_location=DEVICE))
model.eval()

# -------------------
# 彩色映射函数
# -------------------
def decode_segmap(mask):
r = np.zeros_like(mask, dtype=np.uint8)
g = np.zeros_like(mask, dtype=np.uint8)
b = np.zeros_like(mask, dtype=np.uint8)
for l in range(NUM_CLASSES):
idx = mask == l
r[idx], g[idx], b[idx] = VOC_COLORMAP[l]
return np.stack([r, g, b], axis=2)

# -------------------
# 预测函数
# -------------------
def predict(img_tensor):
img_tensor = img_tensor.unsqueeze(0).to(DEVICE)  # batch=1
with torch.no_grad():
out = model(img_tensor)
pred = out.argmax(1).squeeze(0).cpu().numpy()
return decode_segmap(pred)

# -------------------
# 可视化预测
# -------------------
num_image = 10
_, figs = plt.subplots(num_image, 3, figsize=(12, 22))

for i in range(num_image):
img, mask = val_set[i]
mask = mask.squeeze(0).numpy()
pred_color = predict(img)
mask_color = decode_segmap(mask)

img_pil = T.ToPILImage()(img)

figs[i, 0].imshow(img_pil)
figs[i, 0].axis('off')
figs[i, 1].imshow(mask_color)
figs[i, 1].axis('off')
figs[i, 2].imshow(pred_color)
figs[i, 2].axis('off')

# 添加标题
figs[num_image-1, 0].set_title("Image", y=-0.2)
figs[num_image-1, 1].set_title("Label", y=-0.2)
figs[num_image-1, 2].set_title("FCN8s", y=-0.2)

plt.savefig("predict_8s.png")
plt.show()
效果图:
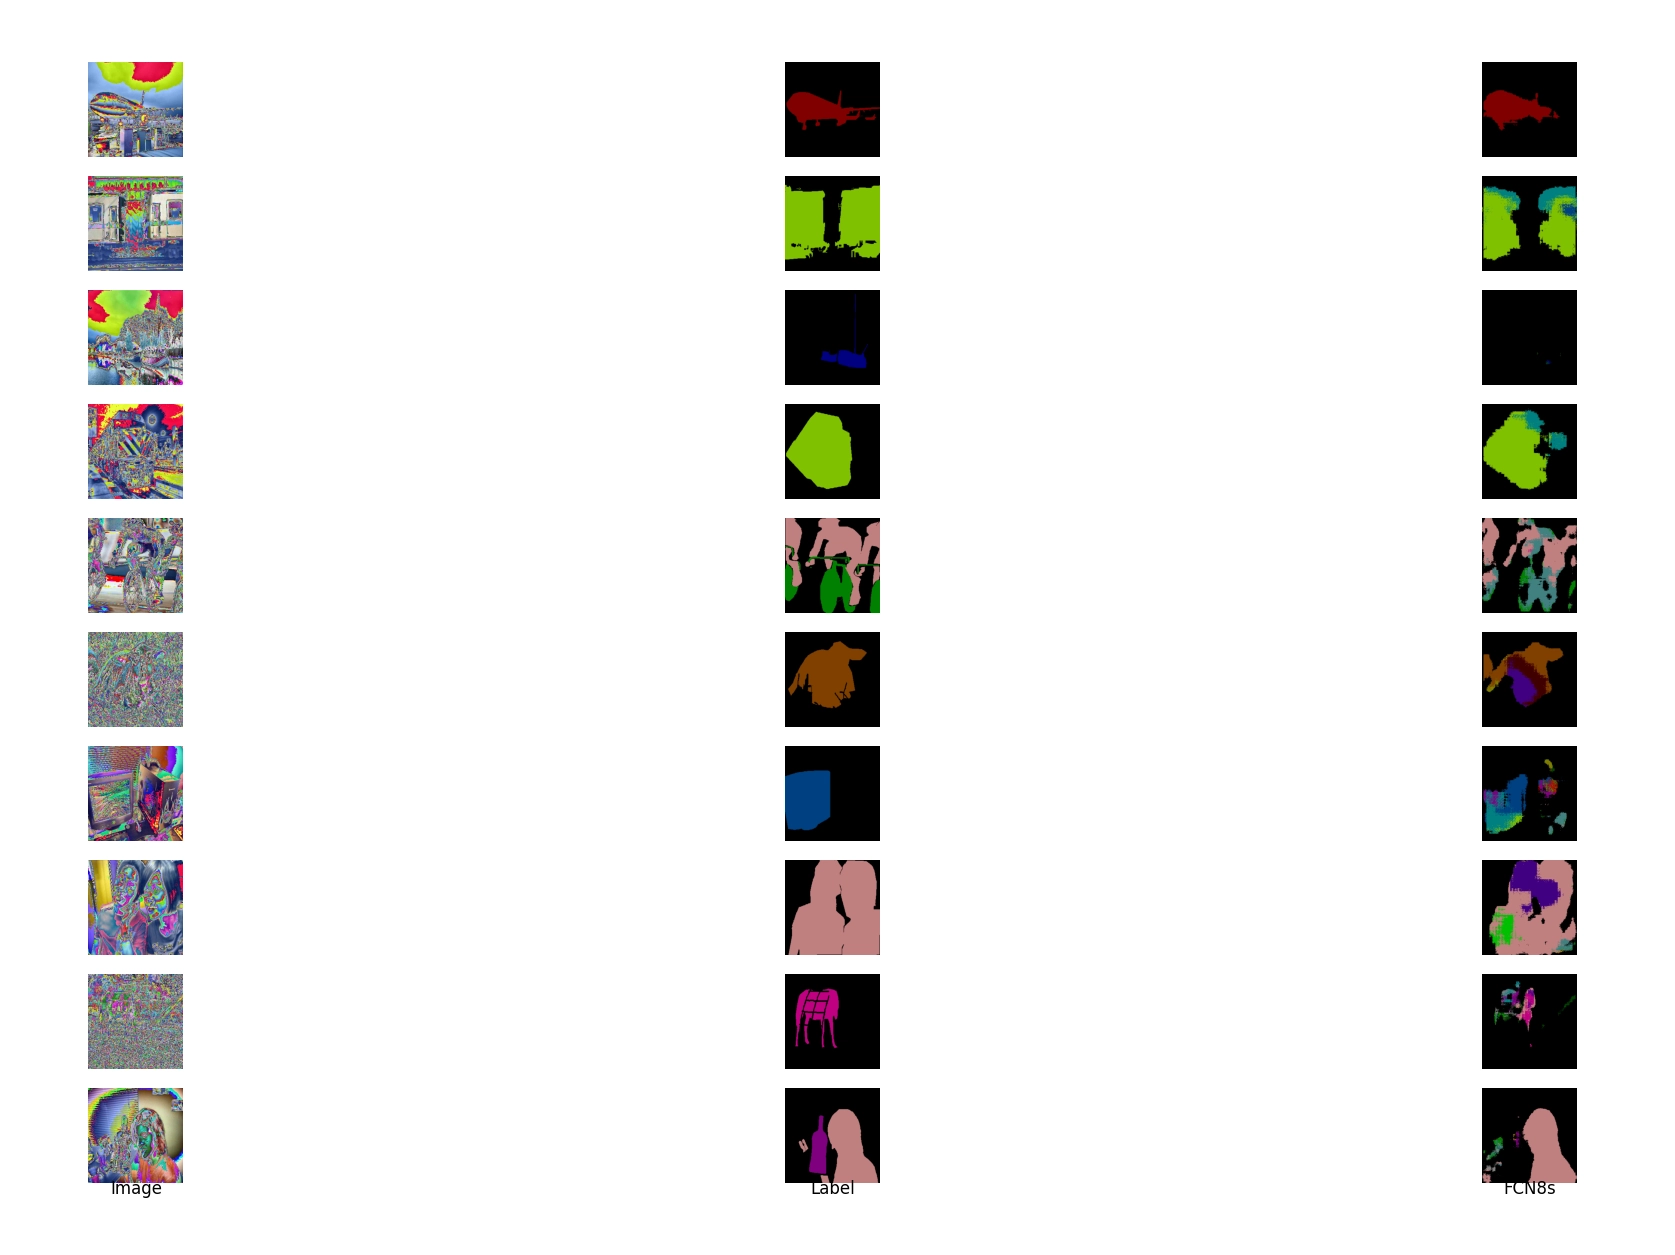
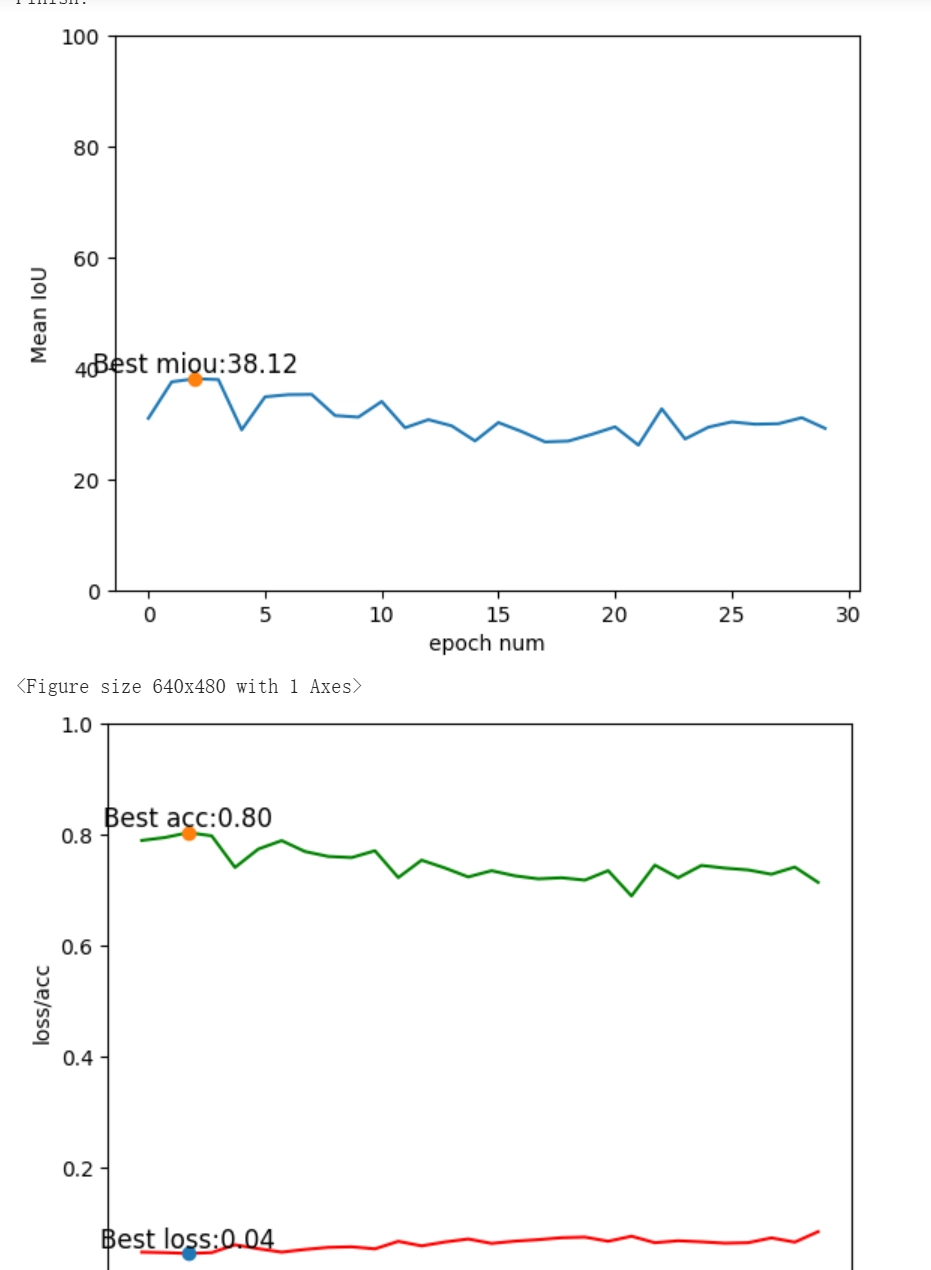
训练了30轮
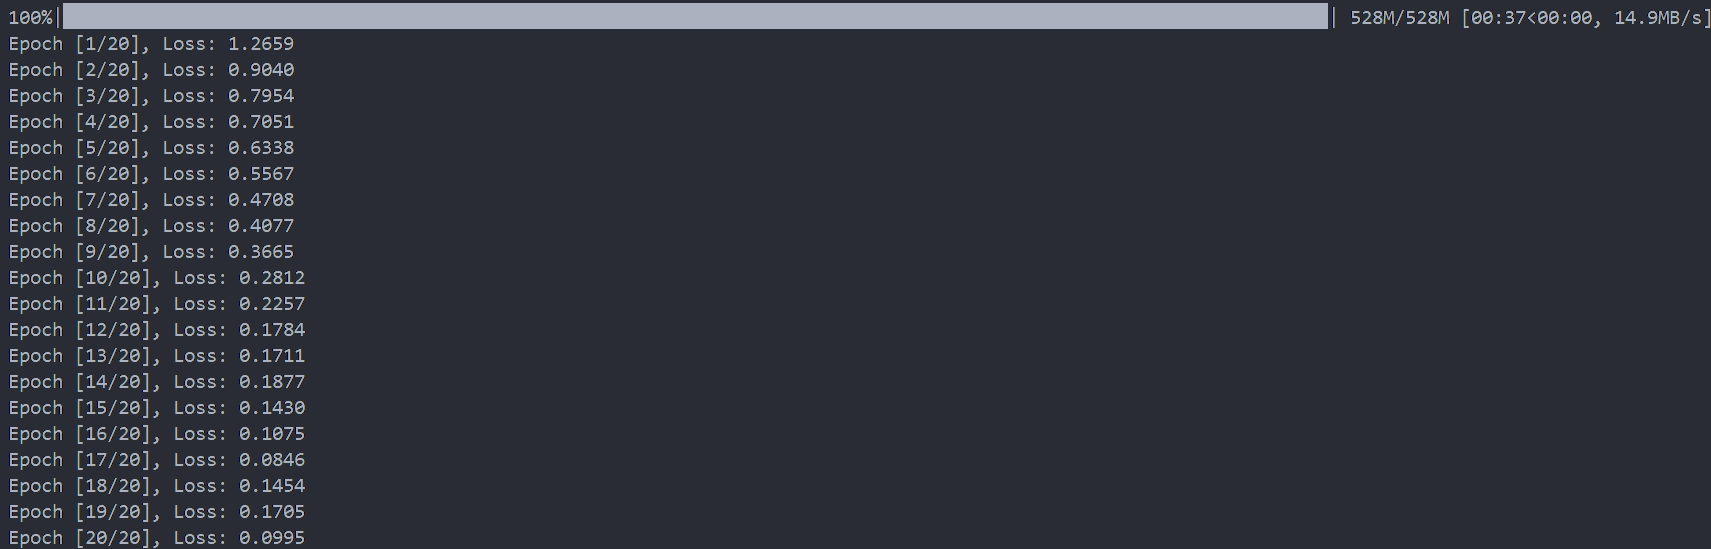
训练过程展示:
评论加载中…