✻
写代码已经不是瓶颈了,瓶颈到了 git、构建和 CI 这些环节。
—— 转述自 Anthropic 工程博客
10 月 13 日,Anthropic 发了一篇工程博客,讲他们为什么自己做了一套版本控制系统。
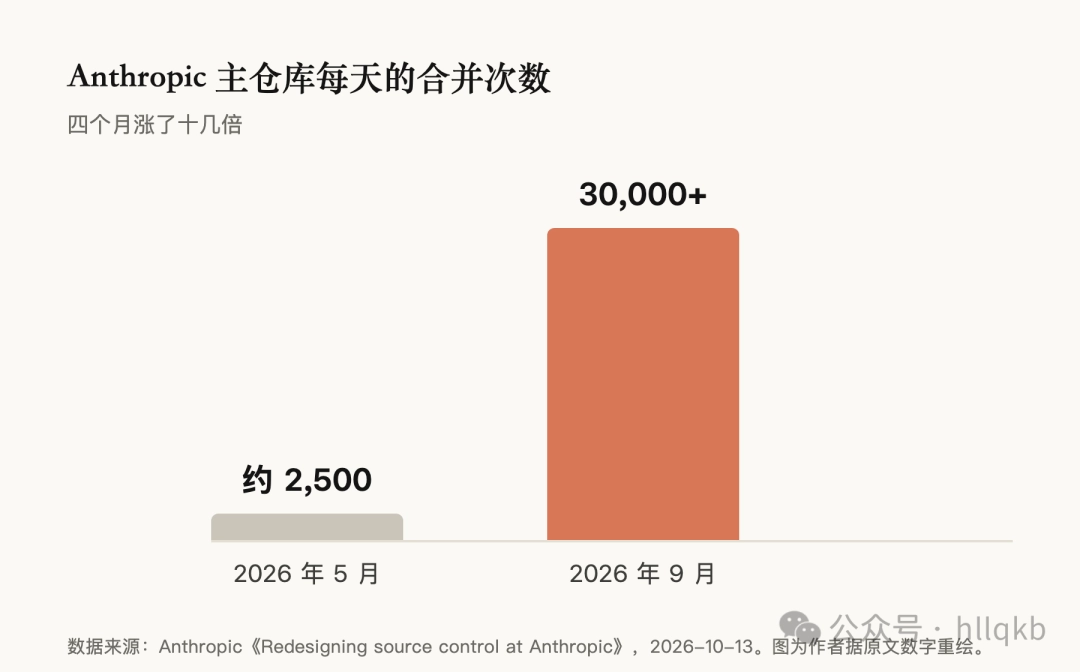
起因是合并量。今年 5 月,他们的主仓库每天大约合并 2500 次,到 9 月超过了 3 万次,Claude 让代码产出涨得太快。主分支历史大约 100GB,CI 每天要 checkout 约 2500 万次,原来的 git 镜像在容量和运维上都吃不消。新系统把提交、合并、rebase 放到服务端执行,文件用到才拉,CI 拉代码从几分钟缩到几秒。
我在一家公司做后端实习,量级跟他们没法比,卡住的原因也不一样。他们是机器扛不住吞吐,我这边多半是拿不准 AI 写的东西到底对不对。相同的一点是,代码写完之后的那些环节,开始比写代码本身更费时间。
本文看点
01测试是绿的,不代表真测过
02三篇 agent 工程文章,和我的对照
03评估这件事,我还没做好
✻ 01 · IN PRACTICE
我这边的情况
实习三个多月,我合了 140 多个 PR,分在 11 个仓库,大部分代码是 Claude Code 和 Codex 写的。我的时间越来越多花在三件事上:看它改了什么,核对测试环境里跑的是不是这版代码,决定这次改动要验到什么程度才算完。这是体感,我没拿数据算过。
踩得最多的几个坑:
●本地跑 lint 太吃内存,两个同时跑会被系统杀掉。后来我就不在本地跑了,交给 CI。
●测试显示通过,不代表真跑过。缺一个依赖工具,相关的那几条测试会自动跳过,结果照样是绿的。
●测试环境就绪了,跑的也不一定是我这次的提交。我会先核对版本号,对上了再测。
✻ 02 · READING NOTES
读到的几篇文章
最近几个月读了些讲 agent 工程的文章,有几篇正好能对上。
✻ 出一次错,补一处环境
Terraform 的作者 Mitchell Hashimoto 今年 2 月写了自己用 AI 的经历,提到“engineer the harness”:agent 每犯一次错,就在它的工作环境里补一样东西,让这类错少犯。补法有两种,一是写进 AGENTS.md 这类说明文件,二是给它写专门的工具,比如截图、只跑相关测试、做验证。
我也是这么一条条补上来的,分两类。一类是说明文件:每个模块目录下有一份 AGENTS.md,要求动代码前先读。它只起提醒作用,AI 偶尔还是会漏看。另一类是钩子,由程序直接拦:数据库迁移有个校验文件只能用命令生成,为了防止 AI 手改,碰它就拦下;一轮对话结束时还有没提交的改动,也会被拦住提醒。
能写成钩子的我尽量写成钩子。说明文件靠模型自觉,钩子不用。
✻ 上下文要管
LangChain 10 月 14 日写了他们的 Deep Agents 怎么管理记忆。按文中的默认配置:工具返回超过约 2 万 token 就存成文件,模型只看一段预览和路径;上下文用到 85% 时把旧消息压成摘要,完整记录另存,需要时能翻回去;skill 平时只给简介,用到才读全文;长期记忆放在一个 markdown 文件里,每次调用模型都带上。文件在自己手里,换了模型也能接着用。
我给 Claude Code 也攒了一个记忆文件夹,现在 141 条,一条记一件事:哪个环境的地址是什么,哪个测试本来就会随机失败,哪类消息不许它自己发出去,某个功能上线后该看哪条日志。另有一个索引,每条一行。开新对话时先读索引,具体内容用到再打开。
好处是不用每次从头交代背景。问题是会过期,我隔一阵就得清一遍,不然它会把三周前的状态当成现在。
✻ 一个写,一个审
Cognition(做 Devin 的公司)去年 6 月写过《Don’t Build Multi-Agents》,反对让多个 agent 同时改代码,理由是每个 agent 都会做别人看不到的决定,合到一起就冲突。今年 4 月同一位作者写了续篇,说法有了调整:多个 agent 一起改代码,现在仍然不太行;只让一个 agent 改,其他 agent 负责审查或者在难题上出主意,这种做法已经能用了。
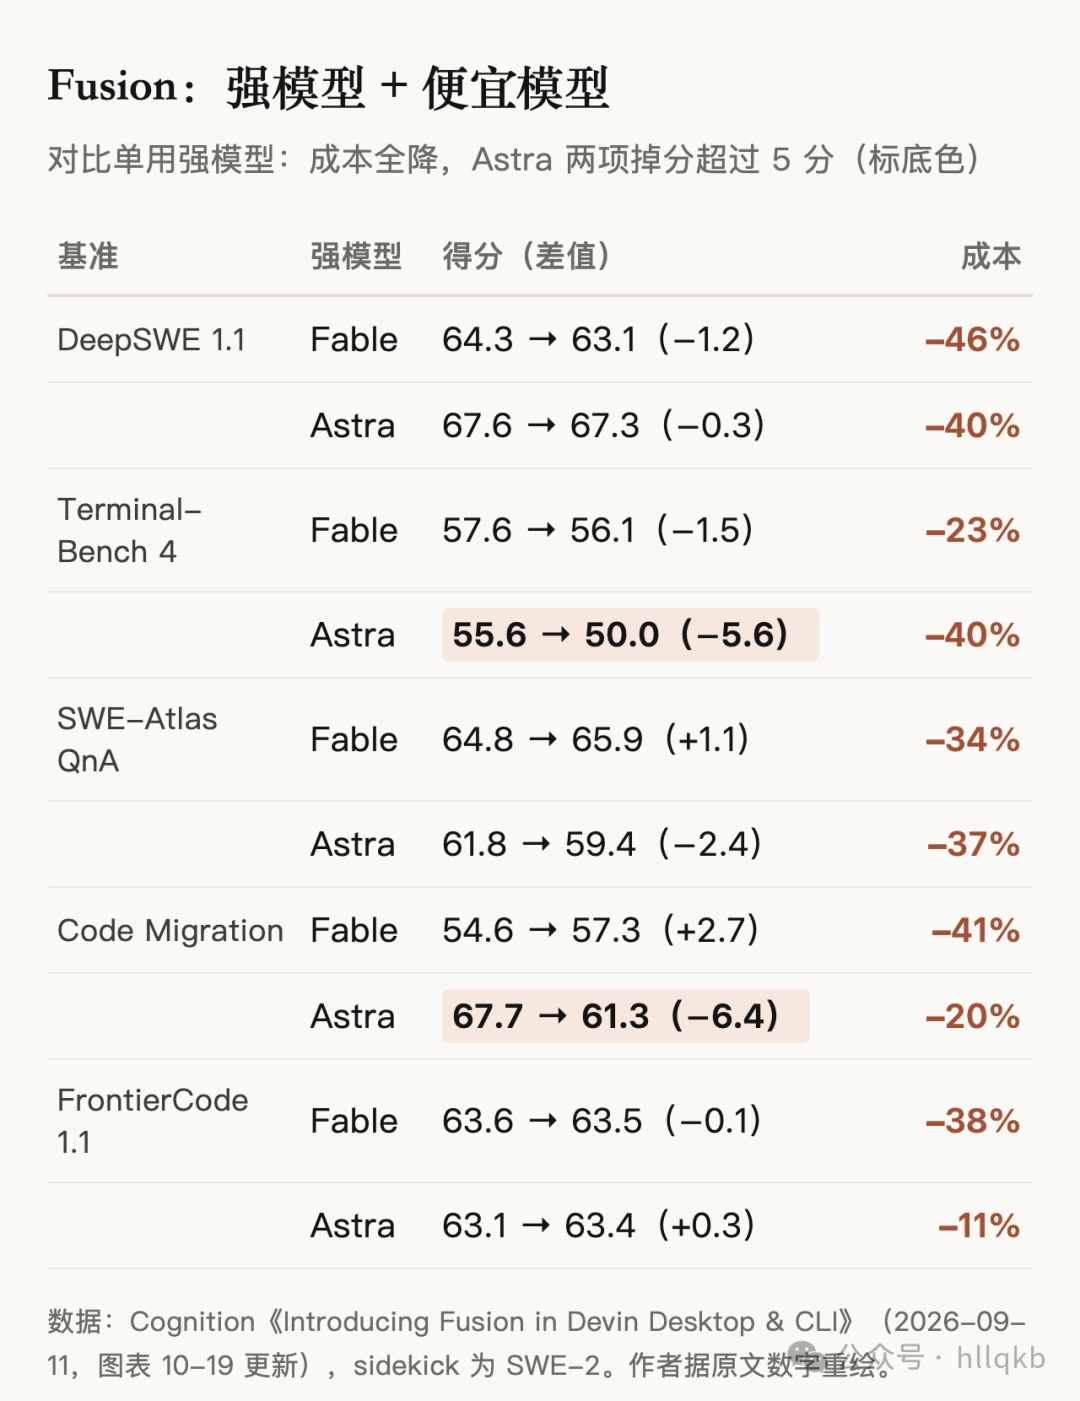
他们 6 月推出的 Fusion 就是这个思路,9 月又放进了桌面端和命令行。一个强模型当 lead,定计划、审结果;一个便宜的模型当 sidekick,翻代码、改代码、跑测试,两边只传任务说明和结果。按他们贴出的数据,成本降了一到四成多。得分方面,Fable 那组和单用强模型基本持平,Astra 那组有两项掉了 5 到 6 分,比如 Terminal-Bench 4 从 55.6 降到 50.0。
我平时的做法简单得多:Claude Code 写完,让 Codex 用高推理强度看一遍这次改动的文件,它提的问题我核过再决定改不改,接近续篇里说的“上下文干净的审查者”。至于效果来自换了个模型,还是来自换了一个没被前面对话带偏的上下文,我没对比过,说不准。
✻ 03 · OPEN QUESTIONS
还没解决的
最难的还是判断一件事做完了没有。
LangChain 10 月 15 日讲 agent 评估的那篇,建议从一个具体行为入手:从真实运行记录里挑 10 到 20 个例子做成测试集,先跑出基线,之后每次改动都跟基线比,线上发现的新失败再补进去。能用代码判断的用代码,判断不了的让模型打分,再用人工抽查这两者。
我做搜索排序时用过类似的办法:拿一批真实的搜索结果,先用规则打分,再让模型抽查,两边一致才往下推。现在回头看,缺了人工校准这一步。规则和模型可能偏向同一种错,两边一致也说明不了结果就是对的。
Anthropic 那篇最后提到,做这套系统的工程师把更多精力放在了定设计约束和审查改动意图上,因为 agent 有时会违反系统约束,或者写一堆没必要的防御代码。我现在花时间最多的,也是想清楚这次要验什么、验到哪一步。
你们用 AI 写代码以后,有没有被“测试是绿的,但其实没测到”坑过?
✻ ✻ ✻
我是 hllqkb,一名后端实习生,在这里记录用 AI 写代码时踩过的坑。
评论加载中…