假设你改了一版搜索排序,开了 A/B 实验,跑了两周,数据上上下下地晃,就是不显著。那这次到底改好了还是改坏了?说不清。
这几天我在补搜索评估的资料,发现这种情况很常见,也有不少现成的办法。下面按我自己理解的顺序整理一遍。
✻ 01 · SCOPE
先想清楚:你到底想知道什么
「排序好不好」其实是三个不同的问题:
1.搜出来的东西和搜索词对不对得上。这叫相关性。
2.用户更爱点哪一版的结果。这是行为偏好。
3.换了排序以后,留存、转化有没有变。这是业务结果。
很多人会把点击直接当成「搜得准」,但这两件事不一样。排在第一位的东西,哪怕一般,被点的机会也比排第二十的好东西大得多,这叫位置偏差。后面讲的几种办法,各自只回答其中一个问题,先想清楚要哪个答案,再挑办法。
✻ 02 · POWER
实验看不出来,先算算样本够不够
A/B 没结论,最先该怀疑的是样本不够。当然也可能改动本来就没什么效果,或者指标选得不对。
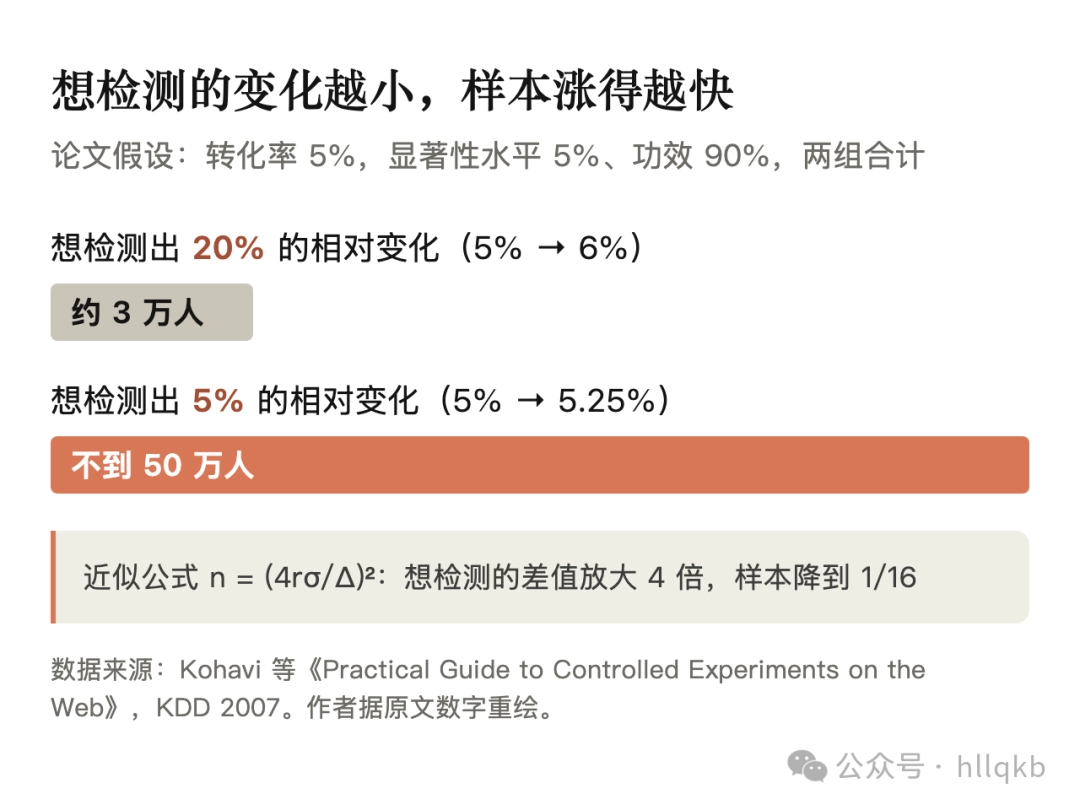
样本要多少,有个现成的估算公式。Ron Kohavi 等人 2007 年在 KDD 发的实验指南里写的是:显著性水平 5%、想有 90% 的把握看出差别、各组人数差不多的时候,总共大约需要 n = (4rσ/Δ)² 个用户。r 是一共几个版本(对照组也算,普通 A/B 就是 2),σ 是指标的标准差,也就是它平时晃得有多厉害,Δ 是你想看出来的最小差别,按绝对值算。
论文里举了个假设的例子:转化率 5%,想看出 5% 的相对变化,也就是从 5% 涨到 5.25%,总共要不到 50 万人;要是只想看出 20% 的相对变化,也就是涨到 6%,3 万多人就够了。差别放大 4 倍,人数降到原来的 1/16,因为公式里是平方。
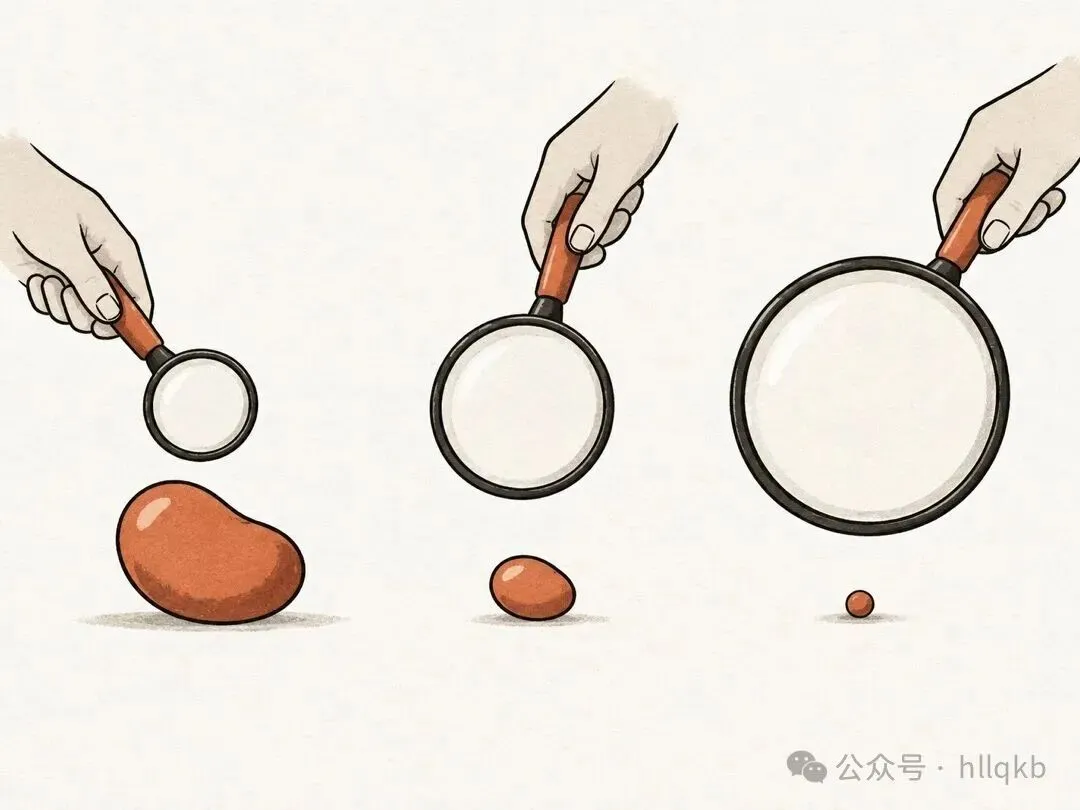
打个比方:想看清的东西越小,放大镜就得越大,而且是成倍地大。
有两个地方容易理解错:
●公式算出来的是「有 90% 的把握看出这么大的变化」要多少人,不是说小于这个变化就一定看不出来。
●不显著不等于没效果。更该看的是效果大概有多大、置信区间有多宽。区间很宽,说明还不知道;区间很窄、紧贴着零,才比较像是真没影响。
所以开实验之前,最好先拿自己的流量和指标的波动算一遍。如果你预计的改动幅度比能看出来的范围小一大截,就提前想别的办法,别等跑完了对着「不显著」发愁。
✻ 03 · SENSITIVITY
样本加不上去,就让实验更灵敏
第一招叫 CUPED,用老数据把噪声扣掉。这是微软的 Deng 等人 2013 年在 WSDM 发的方法。道理是:每个人的行为本来就有高有低,有人天天搜,有人一周搜一次。如果用实验开始前每个人的历史数据,把这部分「本来就有」的差异扣掉,剩下的波动就小多了。论文总结 Bing 上的结果时说,波动(方差)降一半,就只需要一半的用户或者一半的时间。
不过要注意三点:不同指标能扣掉多少差别很大;「时间减半」还要看用户多久回来一次、观察多长时间;拿来扣的历史数据必须是实验开始前的,不能被这次实验影响。另外它不是一种新实验,只是分析 A/B 结果的一种算法。
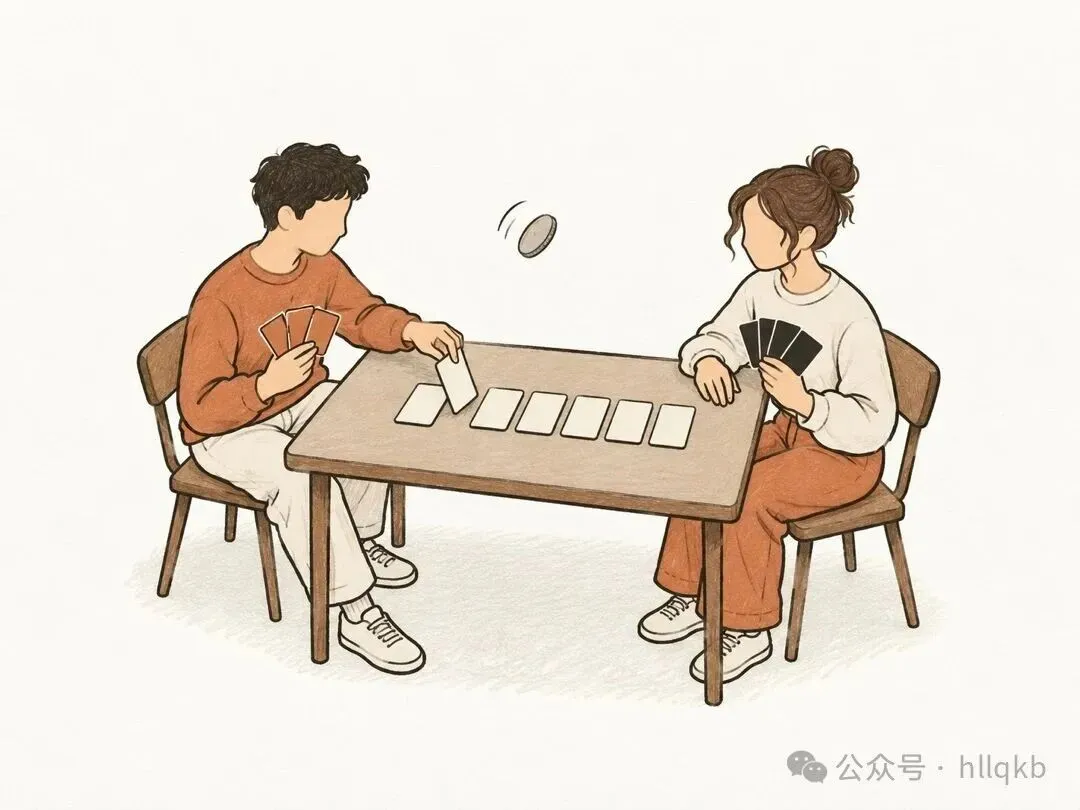
第二招叫交错实验(interleaving),把两版结果混在一起给同一个人看。普通 A/B 是分两拨人、各看一版;交错实验是同一次搜索里,把两版的结果按一定规则混成一个列表,看用户点的更多来自哪一版。
常用的混法叫 Team-Draft,有点像两个队长轮流挑队员:每轮随机决定谁先挑,各自挑自己排序里还没被选走的最好结果,这样哪一版都不会总占着前排。点击记给挑中那条结果的一方。因为是同一个人在同一个列表里比较,人和人之间的差异就不干扰了,比较排序时通常比分组实验灵敏得多。
它的局限是只能告诉你「用户更爱点哪一版」,看不到整页体验、长期留存、收入这些。
✻ 04 · OFFLINE
线上信号不够,就在线下评相关性
还有一种办法是不等用户点,自己准备一批搜索词,给每条结果打「相关不相关」,算个分,两版用同样的词比一比。几个要点:
1.先想好要评什么,再挑词。想知道整体体验,就按真实搜索的频率来挑,热门词多挑;想专门看冷门词,就把热门、中等、冷门分开挑、分开算。两种目的别混在一个平均数里。
2.相关分几档。「很相关、有点相关、不相关」比只分对错更能看出两版的差别。
3.用 NDCG@k 算总分。每条结果按相关程度给分,越靠前的权重越大,最后除以「理想排法」能拿到的分数。k 是只看前几条,比如前 10 条。两版要用同一批词、同一套打分标准、同一个 k。
4.算一下误差。一批词上分数高一点,可能只是碰巧挑到了好词。可以把这批词反复重新抽样来算,看差值的置信区间有多宽。
5.简单规则只能粗筛。比如「结果的标签包含全部搜索词就算相关」,算起来快,但包含了不代表用户想要,没包含也不代表不相关。
✻ 05 · LABELS
打分谁来打:人还是模型
人来标最常见,但慢、贵,而且人也会看错,会对规则理解不一。现在有一种做法是让大模型来标。
微软的 Paul Thomas 等人在 SIGIR 2024 的论文里讲了 Bing 怎么做:先拿真实搜索者的详细反馈当参照,挑出跟这些反馈最一致的模型和提示词,再让模型大批量地标。在他们的设置下,模型标出来的质量能跟人工差不多,在 Bing 的数据上还比他们对比的外包标注员好。论文也提到,提示词只是换个说法,跟参照的一致程度就会变。
所以用模型来打分,一定要留一批没用来调提示词的数据做检验:
1.准备一批人工认真标过的参照答案,尽量贴近真实用户想要什么。
2.按搜索词把它分成两份:一份用来调,一份用来验。同一个词不要两份里都有。
3.在第一份上挑模型、改提示词;定下来以后,只在第二份上看一次准不准。
4.正式评的时候,把两版结果混在一起、不告诉模型哪条来自哪版,免得它偏心。
5.过一阵子再抽一批让人看一遍,确认标准没有慢慢跑偏。
还有一个坑:如果简单规则和模型其实看的是同一份标签,它俩说法一致也证明不了什么,标签一错,两边一起错。这也是为什么要单独留一批人工检验的数据。
✻ ∞ · EPILOGUE
最后
这些办法回答的不是同一个问题。线下评相关性,看的是搜得准不准;交错实验,看的是用户更爱哪一版;A/B 加上 CUPED,看的是业务数据有没有变。流量够,三件事都能做。流量不够,A/B 最后可能还是给不出明确结论,这时候老老实实写「还不确定」,比硬下结论强。
我自己还没想明白的一点:线下评下来相关性变好了,线上点击却变差了,这时候该信哪个?你们碰到过吗?
✻ ✻ ✻
评论加载中…